Curieux.JY
  • JungYeon Lee
  • Post
  • 🕸️ Graph
  • Lecture
  • Note

On this page

  • 🎯 0. 문제 설정: 골짜기 하나 건너기
  • 🐣 1. 가장 단순한 진화 전략: (1+1)-ES
  • 👥 2. 여럿 뽑아 무게중심으로: (μ/μ_w, λ)-ES
  • 🧠 3. CMA-ES 밑바닥 구현
    • 3.1 네 가지 업데이트
    • 3.2 전체 코드
    • 3.3 숫자로 따라가는 한 세대
      • (0) 준비물 — 상수들부터 계산해 보기
      • (1) 샘플링: \mathbf{x}_k = \mathbf{m} + \sigma B D \mathbf{z}_k
      • (2) 선택과 평균 이동
      • (3) 보폭 업데이트: 길이 하나로 판단하기
      • (4) 공분산 업데이트: 두 항이 각각 얼마나 기여하나
      • (5) 100세대 뒤에는?
      • (6) 확인 사살: 학습된 C 는 헤시안의 역행렬을 닮는다
    • 3.4 세 알고리즘 비교
    • 3.5 σ와 조건수는 어떻게 변했나
  • 📦 4. 진짜 라이브러리: pycma
    • 4.1 내 구현 vs pycma
    • 4.2 단조 변환 불변성 확인
  • 🧭 5. 실전 감각
  • 🗂 6. 정리 & 코드
    • Reference

👩‍💻CMA-ES 한 걸음씩: pycma로 배우는 진화 전략

cma-es
optimization
python
numpy
code
미분 없이 최적화하기 — 정규분포 하나를 지형에 맞춰 길들이는 알고리즘을 밑바닥부터 구현하고 pycma와 비교합니다.
Published

August 25, 2026

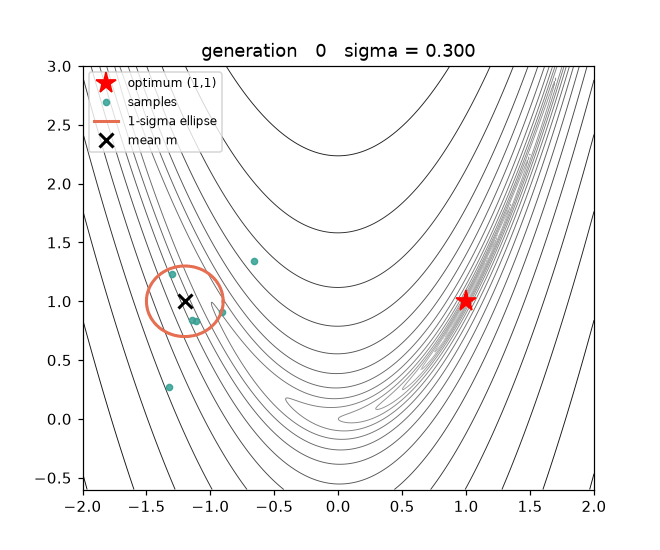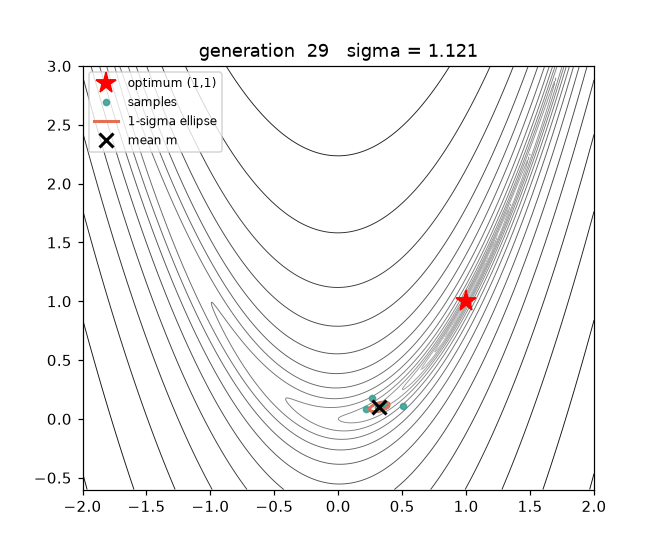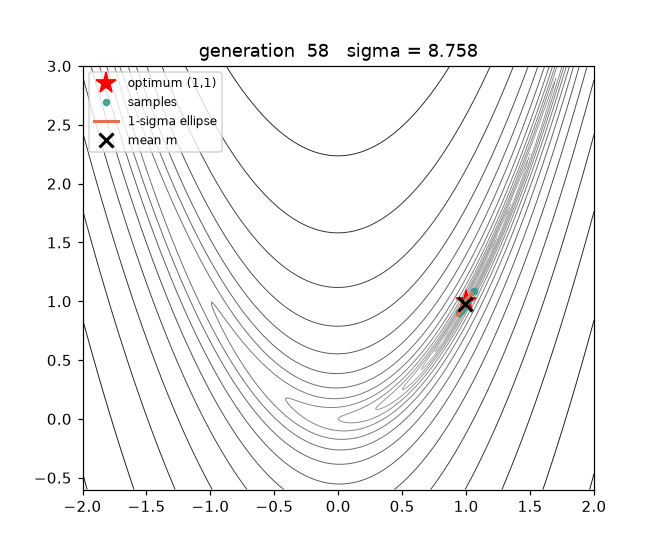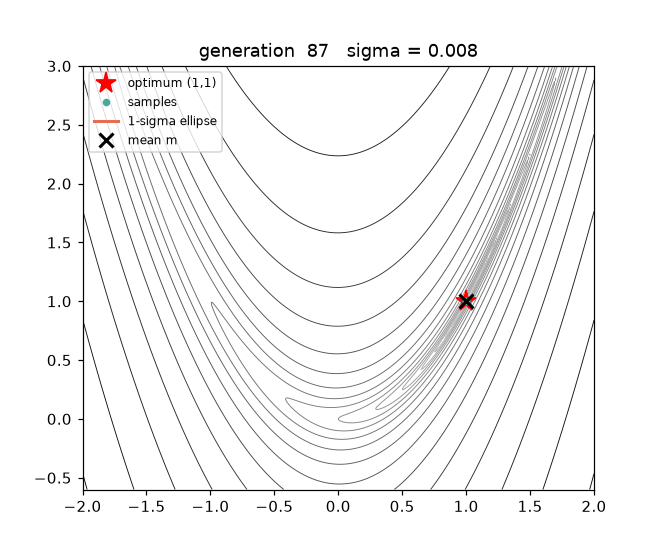
직접 구현한 CMA-ES가 Rosenbrock 골짜기를 따라 내려가는 모습. 주황색 타원이 “지금 어디를 뒤지고 있는가”입니다.

CMA-ES(Covariance Matrix Adaptation Evolution Strategy)는 기울기(gradient)를 쓸 수 없는 문제에서 사실상 표준처럼 쓰이는 최적화 알고리즘입니다. 시뮬레이터 튜닝, 로봇 제어기 파라미터, 하이퍼파라미터 탐색처럼 “함수값은 알 수 있는데 미분은 모르겠는” 상황이 딱 그 무대죠.

이 글은 논문을 요약하는 대신, 코드를 한 줄씩 쌓아 올리면서 왜 각 항이 필요한지를 따라갑니다.

  • 참고 구현: CMA-ES/pycma · 공식 사이트 cma-es.github.io
  • 이 글의 스크립트: curieuxjy/pycma → study/ (원본을 건드리지 않도록 fork에 별도 폴더로 정리했습니다)
Tip이 글의 진행 방식
  1. 미분 없이 최적화한다는 게 뭔지 → (1+1)-ES
  2. 여럿 뽑아 평균으로 이동 → (μ/μ_w, λ)-ES
  3. 분포의 모양까지 학습 → CMA-ES 밑바닥 구현
  4. 진짜 라이브러리 pycma 사용법
  5. 언제 쓰고 언제 쓰지 말아야 하나

🎯 0. 문제 설정: 골짜기 하나 건너기

CMA-ES 이야기의 단골 손님은 Rosenbrock 함수입니다.

f(\mathbf{x}) = \sum_{i=1}^{n-1} \Big[ 100\,(x_i^2 - x_{i+1})^2 + (x_i - 1)^2 \Big]

여기서 n 은 차원(변수 개수), 즉 \mathbf{x}=(x_1,\dots,x_n) 입니다. 대괄호 안에 x_i 와 x_{i+1} 이 짝으로 들어가므로 항의 개수는 n 개가 아니라 n-1 개이고, 변수들이 x_1 \to x_2 \to \cdots \to x_n 처럼 이웃끼리 사슬로 묶입니다.

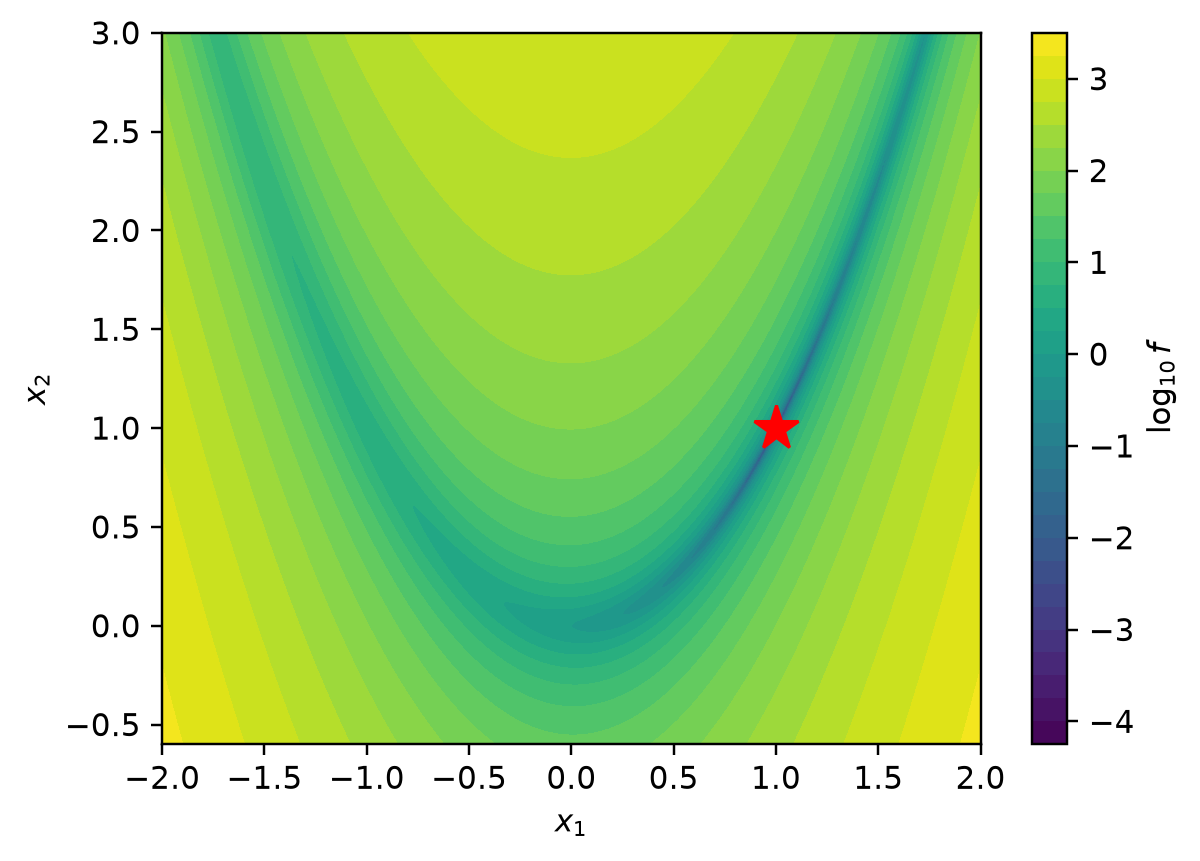
최소값은 \mathbf{x}^*=(1,\dots,1) 에서 0. 그런데 이 함수는 바나나처럼 휘어진 아주 좁고 평평한 골짜기를 가지고 있어서, “무작정 가까운 쪽으로 조금씩” 움직이는 방법은 골짜기 바닥에서 좌우로 튕기기만 하고 앞으로 못 나갑니다.

왜 하필 이 함수가 단골일까요? 세 가지가 겹쳐 있기 때문입니다. ① x_{i+1} 의 최적값이 x_i^2 에 묶여 있어 변수끼리 얽혀 있고(non-separable), 한 변수씩 따로 다루는 방법으로는 원리적으로 풀리지 않습니다. ② 최적점에서의 헤시안 조건수가 약 2,500이라 한 방향이 다른 방향보다 50배쯤 좁습니다. ③ 결정적으로 골짜기 바닥이 포물선이라 위치에 따라 “좋은 방향”이 계속 회전합니다. 조건수만 큰 함수는 올바른 타원을 한 번 배우면 끝이지만, Rosenbrock은 그 타원을 계속 따라 돌려야 합니다. 즉 이 함수는 CMA-ES가 하는 일 — 탐색 분포의 크기와 방향을 지속적으로 적응시키는 능력 — 을 정확히 겨냥해 시험합니다. (다만 어렵기만 한 문제는 아닙니다. 봉우리가 하나뿐이라 CMA-ES는 몇 천 번 평가로 기계 정밀도까지 도달합니다. 다봉 문제는 뒤에서 Rastrigin으로 따로 봅니다.)

Note잠깐, “헤시안 조건수”가 뭔가요?

헤시안 H_{ij} = \partial^2 f / \partial x_i \partial x_j 는 2차 미분을 모아 놓은 행렬, 즉 방향별 곡률표입니다. 최적점에서는 기울기가 0이므로 주변 지형이 사실상 H 하나로 결정됩니다.

f(\mathbf{x}^* + \boldsymbol{\delta}) \approx f(\mathbf{x}^*) + \tfrac{1}{2}\boldsymbol{\delta}^\top H \boldsymbol{\delta}

그 802, -400, 200은 어디서 나오나

n=2 의 f = 100(x_1^2 - x_2)^2 + (x_1 - 1)^2 를 직접 두 번 미분해 봅니다. 1차 미분은

\frac{\partial f}{\partial x_1} = 400\,x_1(x_1^2 - x_2) + 2(x_1 - 1),\qquad \frac{\partial f}{\partial x_2} = -200\,(x_1^2 - x_2)

(1,1) 에서 x_1^2 - x_2 = 0, x_1 - 1 = 0 이므로 둘 다 0 — 최적점이 맞다는 확인입니다. 한 번 더 미분하면

\frac{\partial^2 f}{\partial x_1^2} = \underbrace{400(x_1^2 - x_2)}_{=\,0} + \underbrace{800x_1^2}_{=\,800} + 2 = 802,\qquad \frac{\partial^2 f}{\partial x_1 \partial x_2} = -400\,x_1 = -400,\qquad \frac{\partial^2 f}{\partial x_2^2} = 200

\Rightarrow\quad H = \begin{pmatrix} 802 & -400 \\ -400 & 200 \end{pmatrix}

802 = 800 + 2 에서 800은 골짜기 벽(계수 100에서 온 것), 2는 (x_1-1)^2 항의 기여입니다. 즉 가파름의 99.75%는 골짜기 벽이 만듭니다. 손으로 구한 값을 수치 미분으로 검산해 보죠.

해석적 유도 vs 수치 미분 검산 코드
import numpy as np

f2 = lambda x: 100*(x[0]**2 - x[1])**2 + (x[0] - 1)**2

def num_hessian(f, x, h=1e-4):
    """중앙 차분으로 2차 미분 근사."""
    x = np.asarray(x, float); n = len(x); H = np.zeros((n, n))
    for i in range(n):
        for j in range(n):
            ei = np.eye(n)[i]*h; ej = np.eye(n)[j]*h
            H[i, j] = (f(x+ei+ej) - f(x+ei-ej) - f(x-ei+ej) + f(x-ei-ej)) / (4*h*h)
    return H

H_hand = np.array([[802., -400.], [-400., 200.]])
print("해석적 :\n", H_hand)
print("수치미분:\n", np.round(num_hessian(f2, [1, 1]), 3))
해석적 :
 [[ 802. -400.]
 [-400.  200.]]
수치미분:
 [[ 802. -400.]
 [-400.  200.]]

고유값은 2차방정식 하나

2\times2 행렬의 고유값은 특성방정식 \det(H - \lambda I) = 0 을 풀면 됩니다.

(802-\lambda)(200-\lambda) - (-400)^2 = \lambda^2 - \underbrace{1002}_{\text{tr}\,H}\lambda + \underbrace{400}_{\det H} = 0

여기서 두 계수가 곧 대각합(802+200)과 행렬식(802\cdot200 - 400^2 = 160400 - 160000 = 400)입니다. 행렬식이 40만 대 숫자들의 차이로 겨우 400만 남는다는 게 핵심이에요 — 거의 특이(singular)에 가깝다는 뜻이고, 그래서 조건수가 커집니다. 근의 공식으로

\lambda = \frac{1002 \pm \sqrt{1002^2 - 4\cdot400}}{2} = \frac{1002 \pm \sqrt{1002404}}{2} \;\Rightarrow\; \lambda_1 \approx 1001.60,\quad \lambda_2 \approx 0.3994

두 고유값의 곱은 \det H = 400 으로 묶여 있는데 합은 1002 이니, 한쪽이 1000 근처로 커지면 다른 쪽은 0.4로 짜부라질 수밖에 없습니다. 그 비율이 \kappa = \lambda_1/\lambda_2 \approx 2508 입니다.

근의 공식 vs numpy 검산 코드
tr, det = np.trace(H_hand), np.linalg.det(H_hand)
disc = np.sqrt(tr**2 - 4*det)
lam_hand = np.array([(tr - disc)/2, (tr + disc)/2])

lam, B = np.linalg.eigh(H_hand)          # 대칭행렬 전용 (오름차순 정렬)

print("tr H = %.0f,  det H = %.0f,  판별식^0.5 = %.4f" % (tr, det, disc))
print("근의 공식 :", np.round(lam_hand, 4))
print("numpy     :", np.round(lam, 4))
print("\n고유벡터 (열):\n", np.round(B, 3))
print("\n조건수 kappa      = %.1f" % (lam.max()/lam.min()))
print("등고선 축 비율 = sqrt(kappa) = %.1f" % np.sqrt(lam.max()/lam.min()))
print("축 길이 ~ 1/sqrt(lambda) :", np.round(1/np.sqrt(lam), 4))
tr H = 1002,  det H = 400,  판별식^0.5 = 1001.2013
근의 공식 : [3.9940000e-01 1.0016006e+03]
numpy     : [3.9940000e-01 1.0016006e+03]

고유벡터 (열):
 [[-0.446 -0.895]
 [-0.895  0.446]]

조건수 kappa      = 2508.0
등고선 축 비율 = sqrt(kappa) = 50.1
축 길이 ~ 1/sqrt(lambda) : [1.5824 0.0316]

정리하면

고유값 \lambda 방향 의미
가파른 축 1001.6 (-0.895,\ 0.446) 골짜기를 가로지르는 벽
완만한 축 0.399 (-0.446,\ -0.895) 골짜기를 따라가는 바닥

조건수는 이 둘의 비율 \kappa(H) = \lambda_{\max}/\lambda_{\min} \approx 2508 입니다. \kappa=1 이면 완전한 그릇(구형)이라 가장 쉽고, 클수록 “한 방향은 절벽, 다른 방향은 평지”가 됩니다.

등고선 타원의 축 길이는 1/\sqrt{\lambda} 에 비례하므로, 모양의 비율은 \sqrt{\kappa} \approx 50 — 위 문단의 “50배 좁다”가 이 숫자입니다.

이게 CMA-ES와 직결되는 이유: 학습된 공분산은 C \propto H^{-1} 로 갑니다. H 에서 가파른 방향은 H^{-1} 에서 작아지고(→ 탐색 타원의 짧은 축), 평평한 방향은 커집니다(→ 긴 축). 즉 “가파른 쪽은 조심조심, 평평한 쪽은 성큼성큼” 을 스스로 배우는 것이고, 잘 배웠다면 탐색 타원의 축 비율이 \sqrt{\kappa} 에 수렴해야 합니다. 3.3절 (6)에서 실제로 확인합니다.

덧붙여, 경사하강법의 수렴 속도가 \big(\frac{\kappa-1}{\kappa+1}\big)^2 로 느려진다는 고전적 결과도 같은 \kappa 입니다. 뉴턴법은 H^{-1} 을 곱해 \kappa 를 1로 만들어 버리고, CMA-ES는 미분 없이 C \approx H^{-1} 을 추정해 같은 효과를 냅니다.

그림 그리는 코드 보기
import numpy as np
import matplotlib.pyplot as plt

gx, gy = np.linspace(-2, 2, 400), np.linspace(-0.6, 3, 400)
GX, GY = np.meshgrid(gx, gy)
Z = 100 * (GX**2 - GY)**2 + (GX - 1)**2

fig, ax = plt.subplots(figsize=(6, 4.2), dpi=110)
cs = ax.contourf(GX, GY, np.log10(Z + 1e-9), levels=30, cmap="viridis")
ax.plot(1, 1, "r*", ms=15)
ax.set_xlabel("$x_1$"); ax.set_ylabel("$x_2$")
fig.colorbar(cs, label="$\\log_{10} f$")
plt.show()
Figure 1: n=2 인 Rosenbrock 함수의 log10 등고선. 빨간 별이 최적점 (1,1). 골짜기가 ‘휘어’ 있다는 게 핵심입니다.
Note파인만식 요약: 왜 어려운가?

안대를 쓰고 계곡을 내려간다고 해봅시다. 발로 땅을 툭툭 쳐서 “여기가 더 낮네”만 알 수 있어요(= 함수값만 안다). 계곡이 동서로는 좁고 남북으로는 완만하게 휘어 있다면, 사방으로 똑같은 보폭으로 발을 뻗는 사람은 대부분 벽에 부딪힙니다. 잘 내려가려면 “휘어진 방향으로는 크게, 좁은 방향으로는 작게” 발을 뻗어야 하죠. CMA-ES가 학습하는 게 정확히 그 발 뻗는 모양(공분산 행렬) 입니다.


🐣 1. 가장 단순한 진화 전략: (1+1)-ES

이름 읽는 법: 진화 전략은 (\mu\,\overset{+}{,}\,\lambda)-ES 로 표기하는데, \mu 는 부모 수, \lambda 는 한 세대에 낳는 자식 수입니다. 따라서 (1+1) 은 부모 하나가 자식 하나를 낳는다는 뜻이고, 가운데 + 는 부모와 자식을 합쳐서 좋은 쪽을 남긴다(엘리트 보존)는 표시입니다 — 아래 코드의 if fy < fx 가 정확히 그것이라, 최고값이 절대 나빠지지 않습니다.

규칙은 세 줄입니다.

  1. 지금 위치 \mathbf{x} 주변에 정규분포로 후보 하나를 뽑는다: \mathbf{y} = \mathbf{x} + \sigma\,\mathcal{N}(0, I)
  2. 더 좋으면 옮겨 가고 보폭 \sigma 를 키운다
  3. 나쁘면 제자리에서 보폭을 줄인다 (1/5 성공률 법칙)
import numpy as np

def rosenbrock(x):
    x = np.asarray(x, float)
    return sum(100 * (x[:-1]**2 - x[1:])**2 + (x[:-1] - 1)**2)

def one_plus_one_es(f, x0, sigma0=0.5, budget=3000, seed=0):
    rng = np.random.default_rng(seed)
    x = np.asarray(x0, float); fx, sigma = f(x), sigma0
    hist = []
    for _ in range(budget):
1        y = x + sigma * rng.standard_normal(x.size)
        fy = f(y)
        if fy < fx:
            x, fx = y, fy
2            sigma *= 1.5**0.25
        else:
            sigma *= 1.5**-0.0625
        hist.append(fx)
    return x, fx, np.array(hist)

x1, f1, h1 = one_plus_one_es(rosenbrock, np.zeros(4))
print("x* =", np.round(x1, 4), "\nf* = %.3e" % f1)
1
탐색 분포는 등방(isotropic) 정규분포 — 모든 방향이 대칭입니다.
2
성공하면 키우고 실패하면 줄이는 비율이 대략 성공률 1/5에서 균형을 이룹니다.
x* = [0.9153 0.8374 0.702  0.4907] 
f* = 1.229e-01

3000번이나 평가했는데 f^*\approx 10^{-1}. 골짜기 초입에서 멈췄습니다. 원의 형태로만 탐색해서는 휘어진 계곡을 못 따라간다는 증거예요.

말보다 그림이 빠릅니다. 같은 알고리즘을 2차원에서 돌리면서 매 스텝의 위치·f·\sigma·성공 여부를 전부 기록해 보죠.

로깅하는 버전의 코드 보기
def one_plus_one_logged(f, x0, sigma0=0.5, budget=1500, seed=0):
    rng = np.random.default_rng(seed)
    x = np.asarray(x0, float); fx, sigma = f(x), sigma0
    log = []                                   # (x, f, sigma, 성공 여부)
    for _ in range(budget):
        y = x + sigma * rng.standard_normal(x.size)
        fy = f(y)
        ok = fy < fx
        if ok:
            x, fx = y, fy
            sigma *= 1.5**0.25
        else:
            sigma *= 1.5**-0.0625
        log.append((x.copy(), fx, sigma, ok))
    return log

f2d = lambda x: 100*(x[0]**2 - x[1])**2 + (x[0] - 1)**2
log11 = one_plus_one_logged(f2d, np.array([-1.0, 1.5]))

P     = np.array([t[0] for t in log11])
fbest11 = np.array([t[1] for t in log11])
sig11 = np.array([t[2] for t in log11])
succ  = np.array([t[3] for t in log11], float)
rate  = np.convolve(succ, np.ones(100)/100, mode="valid")   # 100스텝 이동 성공률

fig = plt.figure(figsize=(9.6, 5.6), dpi=100)
gs = fig.add_gridspec(3, 2, width_ratios=[1.05, 1])

# (a) 탐색 경로
ax0 = fig.add_subplot(gs[:, 0])
ax0.contour(GX, GY, np.log10(Z + 1e-9), levels=25, linewidths=.5, cmap="Greys")
sc = ax0.scatter(P[:, 0], P[:, 1], c=np.arange(len(P)), cmap="plasma", s=5)
ax0.plot(1, 1, "r*", ms=15); ax0.plot(-1, 1.5, "ko", ms=6)
ax0.set_title("search path (dot = start, star = optimum)")
ax0.set_xlabel("$x_1$"); ax0.set_ylabel("$x_2$")
fig.colorbar(sc, ax=ax0, label="evaluation")

# (b) 최고 함수값
ax1 = fig.add_subplot(gs[0, 1])
ax1.semilogy(fbest11); ax1.set_ylabel("best $f$"); ax1.grid(alpha=.3)
ax1.set_xlim(0, len(P)); ax1.set_title("best $f$ / step-size / success rate")

# (c) sigma 전체 + 성공률
ax2 = fig.add_subplot(gs[1, 1])
ax2.semilogy(sig11, color="#e76f51")
ax2.set_ylabel("$\\sigma$"); ax2.grid(alpha=.3); ax2.set_xlim(0, len(P))
ax3 = ax2.twinx()
ax3.plot(np.arange(len(rate)) + 100, rate, color="#2a9d8f", lw=1)
ax3.axhline(0.2, ls="--", color="gray", lw=1)
ax3.set_ylabel("success rate", color="#2a9d8f"); ax3.set_ylim(0, 0.6)

# (d) sigma 확대: 성공/실패에 따라 톱니처럼 오르내린다
ax4 = fig.add_subplot(gs[2, 1])
a, b = 600, 680
t = np.arange(a, b)
ax4.step(t, sig11[a:b], where="post", color="#e76f51", lw=1.2)
ax4.scatter(t[succ[a:b] == 1], sig11[a:b][succ[a:b] == 1],
            marker="^", s=28, color="#2a9d8f", zorder=3, label="success (x1.107)")
ax4.scatter(t[succ[a:b] == 0], sig11[a:b][succ[a:b] == 0],
            marker="v", s=18, color="#adb5bd", zorder=3, label="fail (x0.974)")
ax4.set_xlabel("evaluations"); ax4.set_ylabel("$\\sigma$ (zoom)")
ax4.legend(fontsize=7, ncol=2); ax4.grid(alpha=.3)
fig.tight_layout(); plt.show()

print("성공률 전체 평균 = %.3f  (1/5 법칙의 목표: 0.2)" % succ.mean())
print("최종 f = %.3e,  최종 sigma = %.2e" % (fbest11[-1], sig11[-1]))
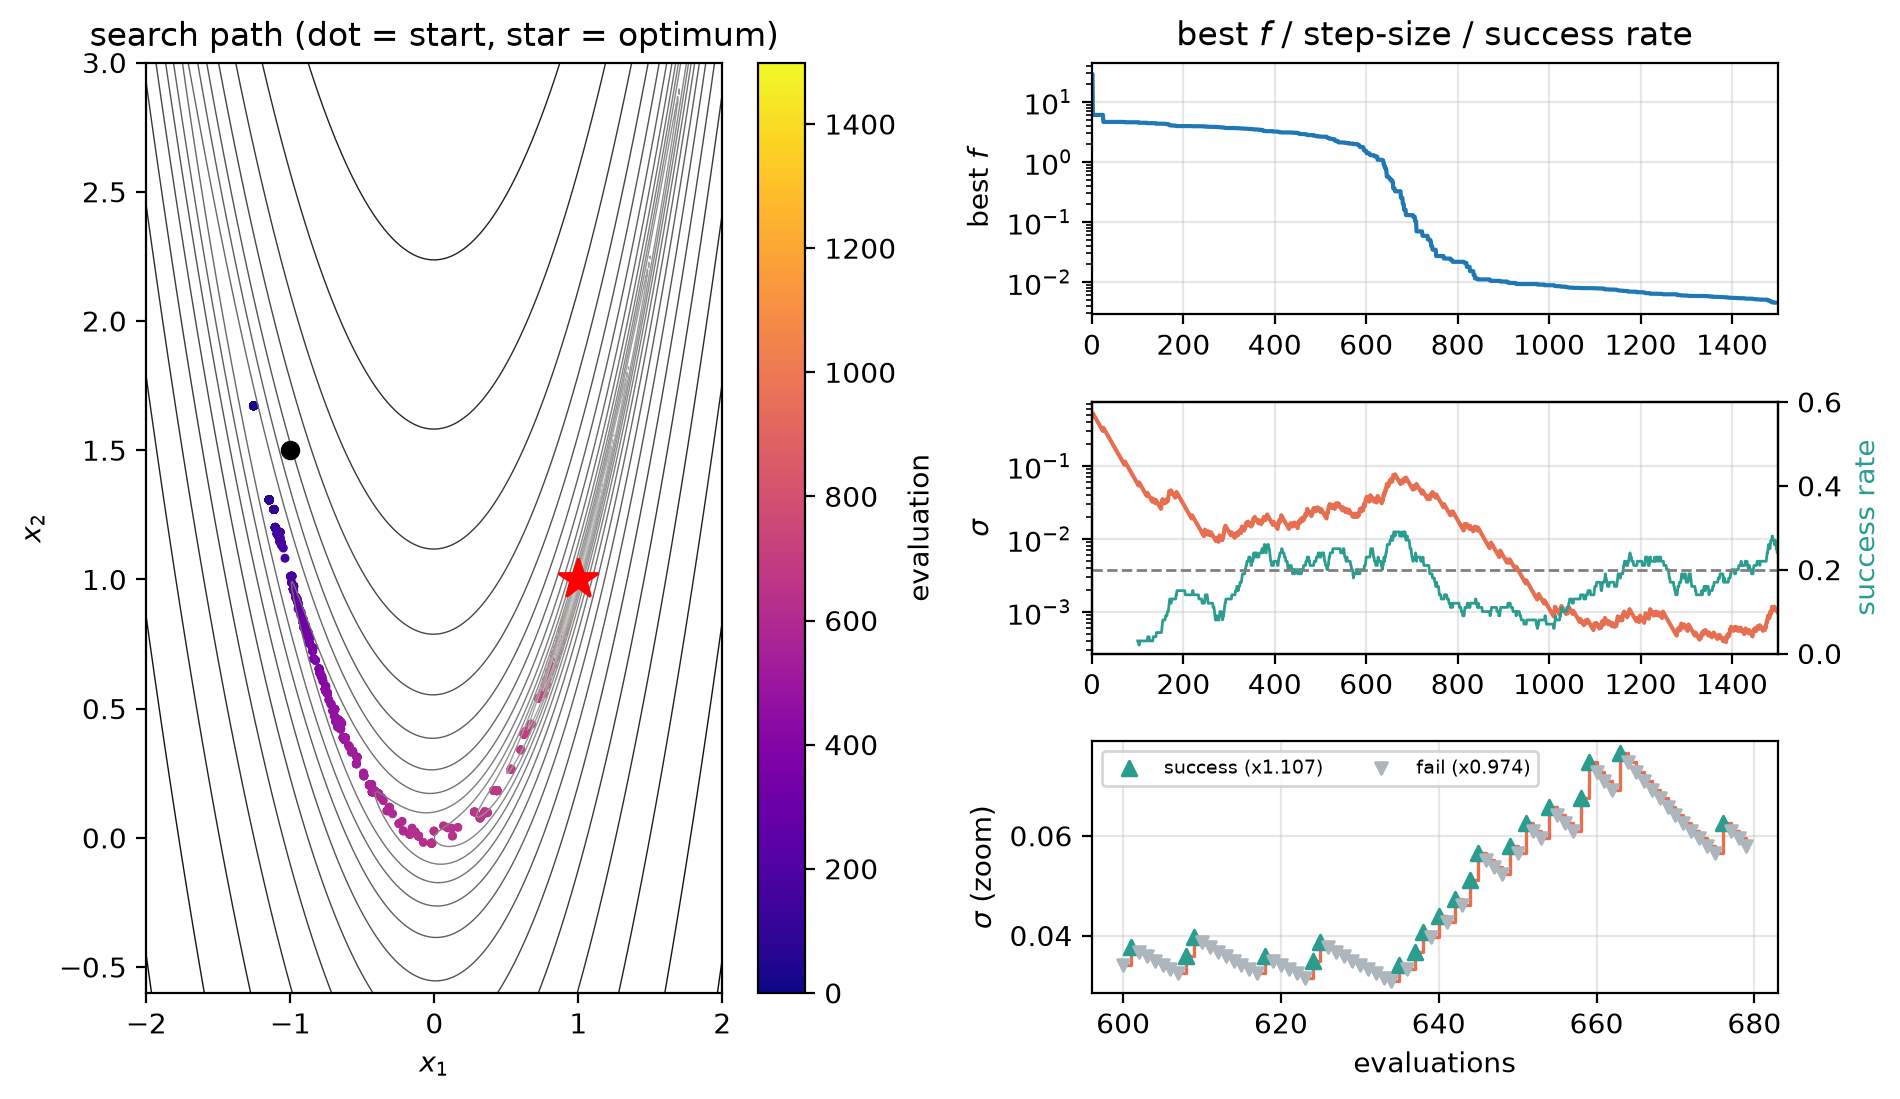
Figure 2: (1+1)-ES의 전 과정. 왼쪽: 이동 경로(색=진행 시점). 오른쪽 위부터 최고 f, 보폭 σ와 성공률, 그리고 σ의 80스텝 확대 — 성공하면 올리고 실패하면 내리는 줄다리기가 보입니다.
성공률 전체 평균 = 0.167  (1/5 법칙의 목표: 0.2)
최종 f = 4.513e-03,  최종 sigma = 1.01e-03

네 그림이 각각 말해 주는 것:

  • 왼쪽(경로): 골짜기까지는 곧장 잘 내려갑니다(보라색 구간). 그런데 바닥에 닿은 뒤부터는 점들이 골짜기를 따라 기어가며 촘촘히 뭉칩니다. 1500번을 다 써도 x_1 \approx 0.5 부근, 별(최적점)까지 절반쯤 남았습니다. 탐색 분포가 원이라 “골짜기를 따라가는 방향”이 뽑힐 확률이 너무 작기 때문이에요.
  • 오른쪽 위(f): 완만한 정체와 급락이 번갈아 나오는 계단 모양입니다. 골짜기 방향이 우연히 잘 맞는 구간에서만 훅 떨어집니다.
  • 오른쪽 가운데(\sigma와 성공률): 성공률(초록)이 목표선 0.2 근처에서 오르내리도록 \sigma(주황)가 자동으로 따라갑니다. 1/5 법칙이 의도대로 작동하는 것이죠. 다만 \sigma 는 처음 0.5에서 약 500배 줄어든 10^{-3} 수준까지 떨어집니다. 좁은 골짜기에서 성공하려면 보폭을 줄이는 수밖에 없고, 보폭이 줄면 전진 속도도 같이 줄어듭니다.
  • 오른쪽 아래(\sigma 확대): 80스텝만 확대해 보면 성공하면 \times 1.107 올리고 실패하면 \times 0.974 내리는 줄다리기가 톱니처럼 보입니다. 실패가 연달아 나오면 슬금슬금 내려가고, 운 좋게 성공이 몰리면 계단처럼 뛰어오릅니다. 이 톱니의 평균 기울기가 0이 되는 지점이 곧 성공률 1/5 입니다 — 상승폭 \ln 1.107 과 하강폭 \ln 0.974 의 비가 대략 1:4 이니, 성공 1번에 실패 4번일 때 균형이 맞는 것이죠.

숫자로 비교하면 잔인합니다. 같은 2차원 문제에서 (1+1)-ES는 1500번 평가에 f \approx 5\times10^{-3}, 뒤에 나올 CMA-ES는 600번 평가에 f \approx 10^{-8} 입니다(3.3절 추적표).

Important이 그림이 CMA-ES의 존재 이유입니다

\sigma 는 “얼마나” 만 조절할 수 있고 “어느 쪽으로” 는 손대지 못합니다. 좁고 휘어진 골짜기에서 등방 분포는 모든 방향으로 똑같이 줄어들 수밖에 없어서, 넓은 방향으로 크게 갈 자유까지 함께 잃습니다. 필요한 건 방향별로 다른 보폭 — 그게 공분산 행렬 C 입니다.


👥 2. 여럿 뽑아 무게중심으로: (μ/μ_w, λ)-ES

이름 읽는 법: 슬래시 뒤의 \mu_w 는 “상위 \mu 개를 가중 평균으로 재조합(recombination)한다”는 표시이고, + 대신 쉼표를 쓴 것은 부모를 남기지 않고 자식 \lambda 개 중에서만 고른다는 뜻입니다. 부모를 버리기 때문에 일시적으로 나빠질 수 있지만, 그 자유가 있어야 보폭을 키워 정체를 벗어날 수 있습니다.

한 개 대신 \lambda 개를 뽑고, 잘한 상위 \mu 개의 가중 평균 방향으로 중심을 옮깁니다. 여기서 중요한 성질 하나가 등장합니다.

Important순위만 쓴다 (rank-based)

CMA-ES는 f 값의 크기를 쓰지 않고 등수만 씁니다. 그래서 f 대신 \log f 나 f^3 을 넣어도 동작이 완전히 동일합니다(단조 변환 불변). 스케일링에 신경 쓸 필요가 없다는 뜻이라 실무에서 굉장히 편합니다.

가중치는 로그 스케일로 줍니다.

w_i \propto \ln\!\Big(\frac{\mu+1}{2}\Big) - \ln i,\qquad \sum_i w_i = 1,\qquad \mu_{\text{eff}} = \frac{1}{\sum_i w_i^2}

\mu_{\text{eff}} 는 “실질적으로 몇 명의 의견을 반영했는가”를 재는 값(유효 표본 수)이고, 뒤에 나오는 모든 학습률의 기준이 됩니다.

def mu_lambda_es(f, x0, sigma0=0.5, budget=3000, seed=0):
    rng = np.random.default_rng(seed)
    m = np.asarray(x0, float); N = m.size
1    lam = 4 + int(3 * np.log(N))
    mu = lam // 2
    w = np.log(mu + 0.5) - np.log(np.arange(1, mu + 1))
    w /= w.sum()
    mueff = 1 / np.sum(w**2)
2    chiN = np.sqrt(N) * (1 - 1/(4*N) + 1/(21*N**2))
    sigma, hist = sigma0, []
    for _ in range(budget // lam):
        z = rng.standard_normal((lam, N))
        x = m + sigma * z
3        idx = np.argsort([f(xi) for xi in x])
        z_sel = z[idx[:mu]]
        step = w @ z_sel
        m = m + sigma * step
        sigma *= np.exp((np.linalg.norm(np.sqrt(mueff) * step) / chiN - 1) / 3)
        hist.append(f(m))
    return m, f(m), np.array(hist)

x2, f2, h2 = mu_lambda_es(rosenbrock, np.zeros(4))
print("x* =", np.round(x2, 4), "\nf* = %.3e" % f2)
1
기본 인구수 \lambda = 4 + \lfloor 3\ln N \rfloor — 차원이 커져도 아주 천천히 늘어납니다.
2
\chi_N = \mathbb{E}\|\mathcal{N}(0,I)\| 의 근사. “무작위 걸음이라면 이 정도 길이겠지”라는 기준자입니다.
3
함수값은 정렬에만 쓰입니다.
x* = [0.8565 0.7329 0.5365 0.2837] 
f* = 3.085e-01

여전히 10^{-1} 수준. 중심은 잘 옮기지만 분포의 모양이 아직 원이기 때문입니다. 1장처럼 2차원에서 값들을 기록해 보면 무엇이 달라졌고 무엇이 그대로인지가 한눈에 보입니다.

로깅하는 버전의 코드 보기
def mu_lambda_logged(f, x0, sigma0=0.5, budget=1500, seed=0):
    rng = np.random.default_rng(seed)
    m = np.asarray(x0, float); N = m.size
    lam = 4 + int(3 * np.log(N)); mu = lam // 2
    w = np.log(mu + 0.5) - np.log(np.arange(1, mu + 1)); w /= w.sum()
    mueff = 1 / np.sum(w**2)
    chiN = np.sqrt(N) * (1 - 1/(4*N) + 1/(21*N**2))
    sigma = sigma0; log = []
    for _ in range(budget // lam):
        z = rng.standard_normal((lam, N))
        X = m + sigma * z
        fv = np.array([f(x) for x in X])
        idx = np.argsort(fv)
        step = w @ z[idx[:mu]]
        ratio = np.linalg.norm(np.sqrt(mueff) * step) / chiN     # sigma를 움직이는 신호
        m = m + sigma * step
        sigma *= np.exp((ratio - 1) / 3)
        log.append((m.copy(), X.copy(), f(m), sigma, ratio, np.linalg.norm(step)))
    return log, lam

runs = {sd: mu_lambda_logged(f2d, np.array([-1.0, 1.5]), seed=sd)[0] for sd in range(6)}
SD = 3                                        # 대표로 자세히 볼 시드
log2 = runs[SD]; lam2d = 6
M    = np.array([t[0] for t in log2])
rat  = np.array([t[4] for t in log2])
ev2  = (np.arange(len(log2)) + 1) * lam2d

fig = plt.figure(figsize=(9.6, 5.6), dpi=100)
gs = fig.add_gridspec(3, 2, width_ratios=[1.05, 1])

ax0 = fig.add_subplot(gs[:, 0])
ax0.contour(GX, GY, np.log10(Z + 1e-9), levels=25, linewidths=.5, cmap="Greys")
allX = np.concatenate([t[1] for t in log2])
ax0.scatter(allX[:, 0], allX[:, 1], s=3, color="#adb5bd", alpha=.5)
ax0.plot(M[:, 0], M[:, 1], "-", color="#264653", lw=1.6)
th = np.linspace(0, 2*np.pi, 100)
for g in [0, 10, 30, 60, 120, len(log2)-1]:                       # 탐색 범위는 늘 '원'
    mg, sg = log2[g][0], log2[g][3]
    ax0.plot(mg[0] + sg*np.cos(th), mg[1] + sg*np.sin(th), color="#e76f51", lw=1.2)
ax0.plot(1, 1, "r*", ms=15); ax0.plot(-1, 1.5, "ko", ms=6)
ax0.set_title("seed %d: samples, mean path, 1-$\\sigma$ circles" % SD)
ax0.set_xlabel("$x_1$"); ax0.set_ylabel("$x_2$")

ax1 = fig.add_subplot(gs[0, 1])
for sd, lg in runs.items():
    ax1.semilogy(ev2, [t[2] for t in lg], lw=.8,
                 color="#264653" if sd == SD else "#adb5bd")
ax1.set_ylabel("$f(m)$"); ax1.grid(alpha=.3)
ax1.set_title("6 seeds: $f$, step-size, driving signal")

ax2 = fig.add_subplot(gs[1, 1])
for sd, lg in runs.items():
    ax2.semilogy(ev2, [t[3] for t in lg], lw=.8,
                 color="#e76f51" if sd == SD else "#f4c7b8")
ax2.set_ylabel("$\\sigma$"); ax2.grid(alpha=.3)

ax3 = fig.add_subplot(gs[2, 1])
ax3.plot(ev2, rat, color="#2a9d8f", lw=1)
ax3.axhline(1.0, ls="--", color="gray")
ax3.set_ylabel("signal / $\\chi_N$")
ax3.set_xlabel("evaluations"); ax3.grid(alpha=.3); ax3.set_ylim(0, 2.5)
fig.tight_layout(); plt.show()

finals = {sd: lg[-1][2] for sd, lg in runs.items()}
print("세대당 평가 수 lambda = %d,  총 %d 세대" % (lam2d, len(log2)))
print("시드별 최종 f(m):", {k: float("%.2e" % v) for k, v in finals.items()})
print("신호 비율 평균(seed %d) = %.3f  (1보다 크면 sigma 증가, 작으면 감소)" % (SD, rat.mean()))
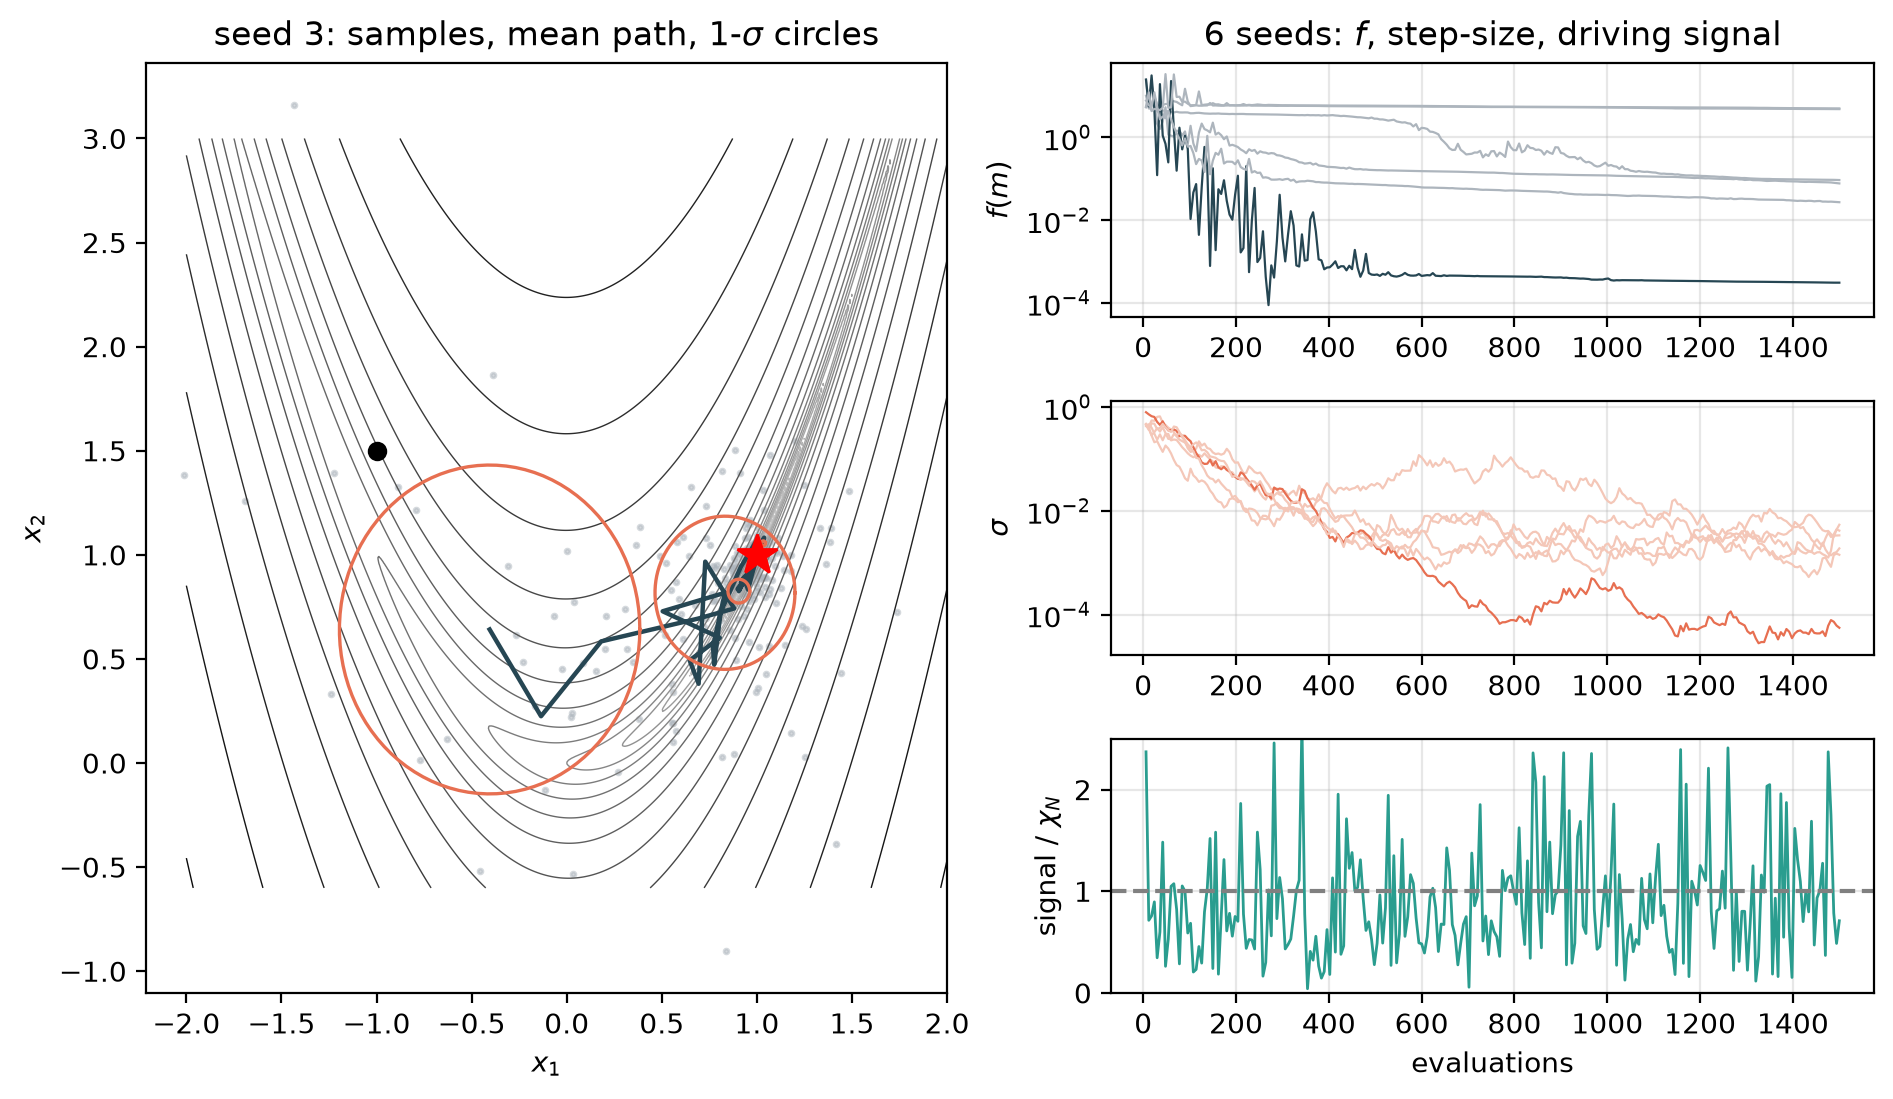
Figure 3: (μ/μ_w, λ)-ES. 왼쪽: 세대별 샘플(옅은 점), 평균의 이동(굵은 선), 몇몇 세대의 1-sigma 탐색 범위(주황 원 — 끝까지 원입니다). 오른쪽: 6개 시드의 f와 sigma, 그리고 sigma를 움직이는 신호.
세대당 평가 수 lambda = 6,  총 250 세대
시드별 최종 f(m): {0: 4.97, 1: 0.0927, 2: 0.0768, 3: 0.000309, 4: 4.78, 5: 0.027}
신호 비율 평균(seed 3) = 0.891  (1보다 크면 sigma 증가, 작으면 감소)

1장과 비교해서 달라진 것, 그대로인 것, 그리고 새로 생긴 문제:

  • 달라진 것 — 판단 근거가 1비트에서 실수로. 1장은 “성공했나?”라는 예/아니오 한 비트로 \sigma 를 조절했습니다. 여기서는 맨 아래 패널의 \sqrt{\mu_{\text{eff}}}\,\|\langle y\rangle_w\| / \chi_N — “무작위로 걸었을 때보다 얼마나 멀리 갔는가” 라는 연속적인 양을 씁니다. 1보다 크면 보폭을 키우고 작으면 줄입니다. 훨씬 정보량이 많은 신호죠.
  • 그대로인 것 — 원은 끝까지 원입니다. 왼쪽 그림의 주황색 1-\sigma 범위를 보세요. 세대가 지나며 크기만 줄어들 뿐 절대 찌그러지지 않습니다. 골짜기는 비스듬히 누워 있는데 탐색 범위는 동그라미라, 뽑은 샘플의 대부분이 골짜기 벽에 부딪힙니다.
  • 새로 생긴 문제 — 편차가 큽니다. 6개 시드 중 2개(0번, 4번)는 f\approx5 에서 그대로 멈췄습니다. 가운데 패널을 보면 그 시드들도 \sigma 는 계속 줄어들고 있어요. 즉 아직 최적점 근처가 아닌데 보폭만 쪼그라든 조기 수렴(premature convergence)입니다.

왜 그럴까요? 맨 아래 신호 패널이 답입니다. 한 세대의 신호가 0.1에서 2.5 사이를 마구 튑니다. \lambda=6 개의 샘플로 방향을 추정하니 당연히 잡음투성이고, 운 나쁘게 짧은 스텝이 몇 번 연달아 나오면 \sigma 가 회복 불능으로 내려가 버립니다.

Note그래서 CMA-ES는 신호를 ’누적’합니다

3장에 나올 진화 경로 \mathbf{p}_\sigma 가 바로 이 잡음의 해법입니다. 한 세대의 스텝을 그대로 쓰지 않고 여러 세대에 걸쳐 지수 이동 평균으로 누적한 뒤 그 길이를 재요. 무작위로 왔다 갔다 하면 서로 상쇄되어 짧아지고, 한 방향으로 꾸준히 가야만 길어집니다. 위 그림처럼 한 세대짜리 잡음에 휘둘리지 않는 이유입니다.

Important여기까지가 \sigma 로 할 수 있는 전부입니다

스칼라 하나(\sigma)는 모든 방향을 동시에 늘리거나 줄일 수 있을 뿐, “이 방향으로만 크게”는 표현하지 못합니다. 이 원을 타원으로 바꾸는 자유도를 주는 것이 다음 장의 공분산 행렬 C 이고, 방금 본 두 가지 결함 — 잡음 많은 보폭 신호와 찌그러지지 않는 분포 — 이 각각 3장의 진화 경로와 공분산 적응으로 해결됩니다.


🧠 3. CMA-ES 밑바닥 구현

CMA-ES의 정식 이름은 (\mu/\mu_w, \lambda)-CMA-ES — 즉 2장의 알고리즘에 공분산 행렬 C 의 적응을 얹은 것입니다. 선택·재조합 방식은 그대로이고, 달라지는 건 어떤 모양의 분포에서 자식을 뽑느냐 하나뿐입니다.

CMA-ES는 세 가지 상태를 들고 다닙니다.

기호 의미 비유
\mathbf{m} 분포의 중심 내가 서 있는 곳
\sigma 전체 보폭 발을 얼마나 크게 뻗나
C 공분산 행렬 어느 방향으로 뻗나 (타원의 모양)

샘플링은 이렇게 씁니다.

\mathbf{x}_k = \mathbf{m} + \sigma\,\mathbf{y}_k,\qquad \mathbf{y}_k \sim \mathcal{N}(0, C) = B D\,\mathcal{N}(0, I)

여기서 C = BD^2B^\top 는 고유분해입니다. B 는 타원의 축 방향, D 는 각 축의 길이. 즉 표준 정규분포를 회전(B)하고 늘려서(D) 지형에 맞는 타원을 만드는 것뿐입니다.

3.1 네 가지 업데이트

  • ① 평균 이동
  • ② 보폭 제어 (CSA)
  • ③ rank-one 업데이트
  • ④ rank-μ 업데이트

\mathbf{m} \leftarrow \mathbf{m} + \sigma \sum_{i=1}^{\mu} w_i\, \mathbf{y}_{i:\lambda}

상위 \mu 개가 가리킨 방향의 가중 평균만큼 이동합니다. 여기까지는 2장과 같습니다.

\mathbf{p}_\sigma \leftarrow (1-c_\sigma)\mathbf{p}_\sigma + \sqrt{c_\sigma(2-c_\sigma)\mu_{\text{eff}}}\; C^{-1/2} \langle \mathbf{y}\rangle_w \sigma \leftarrow \sigma \exp\!\Big(\frac{c_\sigma}{d_\sigma}\Big(\frac{\|\mathbf{p}_\sigma\|}{\chi_N}-1\Big)\Big)

핵심 직관: 연속된 스텝들을 더해 놓은 게 \mathbf{p}_\sigma(진화 경로)입니다.

  • 스텝들이 한 방향으로 계속 갔다 → 경로가 길다 → 너무 조심스럽게 걷고 있다 → \sigma 를 키운다
  • 스텝들이 왔다 갔다 상쇄된다 → 경로가 짧다 → 지나치게 크게 뛰고 있다 → \sigma 를 줄인다

C^{-1/2} 를 곱하는 이유는, 타원으로 늘어난 좌표계를 다시 원으로 되돌려 놓고 길이를 재기 위해서입니다. 그래야 \chi_N 이라는 기준자와 공정하게 비교됩니다.

\mathbf{p}_c \leftarrow (1-c_c)\mathbf{p}_c + h_\sigma\sqrt{c_c(2-c_c)\mu_{\text{eff}}}\;\langle \mathbf{y}\rangle_w C \;\mathrel{+}= \; c_1 \,\mathbf{p}_c \mathbf{p}_c^\top

여러 세대에 걸쳐 꾸준히 향한 방향(\mathbf{p}_c)을 공분산에 직접 새겨 넣습니다. 골짜기를 따라 길게 늘어난 타원이 생기는 주범이 이 항이에요. 세대 하나의 정보만으로는 절대 못 만드는 장기 기억입니다.

C \;\mathrel{+}=\; c_\mu \sum_{i=1}^{\mu} w_i\, \mathbf{y}_{i:\lambda}\mathbf{y}_{i:\lambda}^\top

이번 세대에서 성공한 스텝들의 공분산을 그대로 섞습니다. 인구가 많을수록(\mu_{\text{eff}} 클수록) 이 항이 신뢰할 만해집니다. ③이 장기 기억이라면 ④는 단기 기억입니다.

Note왜 두 개나 필요한가?

rank-μ 는 정보가 풍부하지만 \mu 가 작으면 노이즈가 큽니다. rank-one 은 방향 하나만 잡지만 부호가 상쇄되지 않도록 경로에 누적해 두어서 소수의 샘플로도 안정적입니다. 둘을 c_1, c_\mu 로 섞어 쓰는 게 CMA-ES의 실용적 균형점입니다.

3.2 전체 코드

Code
class MiniCMA:
    def __init__(self, x0, sigma0, seed=0):
        self.rng = np.random.default_rng(seed)
        self.m = np.asarray(x0, float)
        N = self.N = self.m.size
        self.sigma = sigma0
        # --- 선택 파라미터 ---
        self.lam = 4 + int(3 * np.log(N))
        self.mu = self.lam // 2
        w = np.log(self.mu + 0.5) - np.log(np.arange(1, self.mu + 1))
        self.w = w / w.sum()
        self.mueff = 1 / np.sum(self.w**2)
        # --- 적응(학습률) 파라미터: 전부 N과 mueff만으로 정해진다 ---
        self.cc = (4 + self.mueff/N) / (N + 4 + 2*self.mueff/N)
        self.cs = (self.mueff + 2) / (N + self.mueff + 5)
        self.c1 = 2 / ((N + 1.3)**2 + self.mueff)
        self.cmu = min(1 - self.c1,
                       2 * (self.mueff - 2 + 1/self.mueff) / ((N + 2)**2 + self.mueff))
        self.damps = 1 + 2*max(0, np.sqrt((self.mueff - 1)/(N + 1)) - 1) + self.cs
        self.chiN = np.sqrt(N) * (1 - 1/(4*N) + 1/(21*N**2))
        # --- 상태 ---
        self.pc = np.zeros(N); self.ps = np.zeros(N)
        self.C = np.eye(N); self.B = np.eye(N); self.D = np.ones(N)
        self.counteval = 0; self.gen = 0

    def _eigen(self):
        self.C = np.triu(self.C) + np.triu(self.C, 1).T      # 대칭 강제
        d, self.B = np.linalg.eigh(self.C)
        self.D = np.sqrt(np.maximum(d, 1e-20))

    def ask(self):
        """lambda개의 후보를 내놓는다."""
        self._eigen()
        z = self.rng.standard_normal((self.lam, self.N))
        return self.m + self.sigma * (z @ (self.B * self.D).T)

    def tell(self, x, fvals):
        """평가 결과를 받아 m, sigma, C를 갱신한다."""
        idx = np.argsort(fvals)
        self.counteval += len(fvals); self.gen += 1
        y_sel = (x[idx[:self.mu]] - self.m) / self.sigma
        yw = self.w @ y_sel

        self.m = self.m + self.sigma * yw                                  # ①

        invsqrtC = self.B @ np.diag(1/self.D) @ self.B.T                   # ②
        self.ps = ((1 - self.cs) * self.ps
                   + np.sqrt(self.cs*(2 - self.cs)*self.mueff) * invsqrtC @ yw)
        self.sigma *= np.exp((self.cs/self.damps)
                             * (np.linalg.norm(self.ps)/self.chiN - 1))

        hsig = (np.linalg.norm(self.ps)
                / np.sqrt(1 - (1 - self.cs)**(2*self.gen)) / self.chiN
                < 1.4 + 2/(self.N + 1))                                    # ③
        self.pc = ((1 - self.cc) * self.pc
                   + hsig * np.sqrt(self.cc*(2 - self.cc)*self.mueff) * yw)

        ar = (1 - hsig) * self.cc * (2 - self.cc)
        self.C = ((1 - self.c1 - self.cmu) * self.C
                  + self.c1 * (np.outer(self.pc, self.pc) + ar * self.C)   # rank-one
                  + self.cmu * (y_sel.T * self.w) @ y_sel)                 # rank-mu

    def optimize(self, f, maxeval=20000, ftarget=1e-12, record=False):
        log = []
        while self.counteval < maxeval:
            x = self.ask()
            fv = np.array([f(xi) for xi in x])
            self.tell(x, fv)
            if record:
                log.append((self.counteval, fv.min(), self.sigma,
                            self.m.copy(), self.C.copy()))
            if fv.min() < ftarget:
                break
        return self.m, log

es = MiniCMA(np.zeros(4), 0.5)
m, log = es.optimize(rosenbrock, record=True)
print("x* =", np.round(m, 6))
print("f* = %.3e   (evaluations = %d)" % (rosenbrock(m), es.counteval))
x* = [1.       1.       1.       1.000001]
f* = 2.470e-13   (evaluations = 1608)
Warninghsig 는 뭔가요?

보폭 경로 \|\mathbf{p}_\sigma\| 가 비정상적으로 커졌다는 건 \sigma 가 빠르게 증가하는 중이라는 뜻입니다. 이때 공분산까지 같이 부풀리면 발산하기 쉬워서, rank-one 갱신을 잠시 꺼두는 안전장치가 hsig 입니다. 논문에는 한 줄로 나오지만 없으면 고차원에서 꽤 불안정해집니다.

3.3 숫자로 따라가는 한 세대

수식만 보면 추상적이니, 2차원 문제에서 실제 숫자가 어떻게 바뀌는지 한 세대를 통째로 손으로 따라가 보겠습니다. 아래 값들은 전부 실제 실행 결과입니다.

(0) 준비물 — 상수들부터 계산해 보기

N=2 일 때 파라미터가 어떤 값이 되는지 봅니다.

N = 2
lam = 4 + int(3 * np.log(N)); mu = lam // 2
w = np.log(mu + 0.5) - np.log(np.arange(1, mu + 1)); w /= w.sum()
mueff = 1 / np.sum(w**2)

print(f"lambda = {lam},  mu = {mu}")
print("weights w =", np.round(w, 4), " (합 = %.1f)" % w.sum())
print("mueff  = %.4f   <- '유효 표본 수'" % mueff)
print("cs     = %.4f   <- sigma 경로 학습률"   % ((mueff + 2)/(N + mueff + 5)))
print("cc     = %.4f   <- C 경로 학습률"       % ((4 + mueff/N)/(N + 4 + 2*mueff/N)))
print("c1     = %.4f   <- rank-one 학습률"     % (2/((N + 1.3)**2 + mueff)))
print("chiN   = %.4f   <- E||N(0,I)|| 근사"    % (np.sqrt(N)*(1 - 1/(4*N) + 1/(21*N**2))))
lambda = 6,  mu = 3
weights w = [0.637  0.2846 0.0784]  (합 = 1.0)
mueff  = 2.0286   <- '유효 표본 수'
cs     = 0.4462   <- sigma 경로 학습률
cc     = 0.6246   <- C 경로 학습률
c1     = 0.1548   <- rank-one 학습률
chiN   = 1.2543   <- E||N(0,I)|| 근사

읽는 법:

  • \lambda=6 개를 뽑아 상위 \mu=3 개만 씁니다. 가중치는 [0.637, 0.285, 0.078] — 1등의 표가 3등의 8배입니다.
  • \mu_{\text{eff}} \approx 2.0: “3명을 뽑았지만 실질적으로는 2명 몫의 정보”라는 의미입니다. w 가 균등하면 \mu_{\text{eff}}=\mu, 1등에게 몰아주면 \mu_{\text{eff}}\to 1 로 갑니다.
  • c_1 \approx 0.16: 공분산의 약 16%씩만 새 정보로 갈아 끼웁니다. 학습률이 작다는 건 관성이 크다 = 노이즈에 잘 안 흔들린다는 뜻이에요.
  • \chi_N \approx 1.254: 2차원 표준정규 벡터의 평균 길이. “\sqrt{N}=1.414 보다 조금 작다”가 감각입니다.

(1) 샘플링: \mathbf{x}_k = \mathbf{m} + \sigma B D \mathbf{z}_k

C = I 에서 출발하니 첫 세대의 타원은 아직 원입니다.

es2 = MiniCMA(np.array([-1.0, 1.5]), 0.4, seed=42)

X = es2.ask()
fv = np.array([100*(x[0]**2 - x[1])**2 + (x[0]-1)**2 for x in X])

print("m     =", np.round(es2.m, 4), "   sigma =", es2.sigma)
print("C     =\n", np.round(es2.C, 4))
print("\n  k |        x_k        |     f(x_k)   | 순위")
order = np.argsort(np.argsort(fv))
for k in range(len(X)):
    print(f"  {k} | {np.round(X[k],4)} | {fv[k]:11.4f} |  {order[k]+1}")
m     = [-1.   1.5]    sigma = 0.4
C     =
 [[1. 0.]
 [0. 1.]]

  k |        x_k        |     f(x_k)   | 순위
  0 | [-0.8781  1.084 ] |     13.3194 |  2
  1 | [-0.6998  1.8762] |    195.1217 |  4
  2 | [-1.7804  0.9791] |    487.6675 |  6
  3 | [-0.9489  1.3735] |     26.1861 |  3
  4 | [-1.0067  1.1588] |      6.1380 |  1
  5 | [-0.6482  1.8111] |    196.1772 |  5

(2) 선택과 평균 이동

상위 3개만 남기고, 정규화된 스텝 \mathbf{y}_i = (\mathbf{x}_i - \mathbf{m})/\sigma 에 가중치를 곱해 더합니다.

idx = np.argsort(fv)
y_sel = (X[idx[:es2.mu]] - es2.m) / es2.sigma
yw = es2.w @ y_sel

for i, y in enumerate(y_sel):
    print(f"{i+1}등: y = {np.round(y,4)},  w = {es2.w[i]:.4f},  w*y = {np.round(es2.w[i]*y,4)}")
print("\n<y>_w =", np.round(yw, 4), "  (가중 평균 방향, 길이 %.4f)" % np.linalg.norm(yw))

m_new = es2.m + es2.sigma * yw
print("m_old =", np.round(es2.m, 4))
print("m_new = m_old + sigma * <y>_w =", np.round(m_new, 4))
1등: y = [-0.0168 -0.853 ],  w = 0.6370,  w*y = [-0.0107 -0.5434]
2등: y = [ 0.3047 -1.04  ],  w = 0.2846,  w*y = [ 0.0867 -0.2959]
3등: y = [ 0.1278 -0.3162],  w = 0.0784,  w*y = [ 0.01   -0.0248]

<y>_w = [ 0.086  -0.8642]   (가중 평균 방향, 길이 0.8684)
m_old = [-1.   1.5]
m_new = m_old + sigma * <y>_w = [-0.9656  1.1543]
Note왜 \sigma 로 나눴다가 다시 곱하나?

\mathbf{y} 는 “보폭 1개 단위로 몇 걸음” 인지를 나타내는 무차원 값입니다. 보폭이 변해도 방향 정보는 그대로 재사용할 수 있게 하려는 것이죠. 진화 경로 \mathbf{p}_c,\mathbf{p}_\sigma 도 모두 이 \mathbf{y} 단위로 누적됩니다.

(3) 보폭 업데이트: 길이 하나로 판단하기

\mathbf{p}_\sigma 는 C^{-1/2} 로 좌표를 되돌린 스텝을 누적합니다. 첫 세대엔 C=I 라 그냥 \langle\mathbf{y}\rangle_w 그대로예요.

cs, damps, chiN = es2.cs, es2.damps, es2.chiN
invsqrtC = es2.B @ np.diag(1/es2.D) @ es2.B.T

ps = (1 - cs)*es2.ps + np.sqrt(cs*(2 - cs)*es2.mueff) * invsqrtC @ yw
ratio = np.linalg.norm(ps) / chiN
factor = np.exp((cs/damps) * (ratio - 1))

print("계수 sqrt(cs(2-cs)mueff) = %.4f" % np.sqrt(cs*(2-cs)*es2.mueff))
print("p_sigma      =", np.round(ps, 4), "  ||p_sigma|| = %.4f" % np.linalg.norm(ps))
print("chiN         = %.4f" % chiN)
print("||p||/chiN   = %.4f   -> %s" % (ratio, "기대보다 길다 → sigma 증가"
                                       if ratio > 1 else "기대보다 짧다 → sigma 감소"))
print("배율 exp(cs/damps * (ratio-1)) = %.5f" % factor)
print("sigma: %.4f -> %.4f" % (es2.sigma, es2.sigma*factor))
계수 sqrt(cs(2-cs)mueff) = 1.1859
p_sigma      = [ 0.102  -1.0248]   ||p_sigma|| = 1.0299
chiN         = 1.2543
||p||/chiN   = 0.8211   -> 기대보다 짧다 → sigma 감소
배율 exp(cs/damps * (ratio-1)) = 0.94631
sigma: 0.4000 -> 0.3785

한 세대에 \sigma 가 바뀌는 폭이 몇 % 수준이라는 데 주목하세요. d_\sigma(damping)가 브레이크 역할을 해서 폭주하지 않고 지수적으로 부드럽게 조절됩니다.

(4) 공분산 업데이트: 두 항이 각각 얼마나 기여하나

hsig = (np.linalg.norm(ps) / np.sqrt(1 - (1 - cs)**2) / chiN) < (1.4 + 2/(N + 1))
pc = (1 - es2.cc)*es2.pc + hsig*np.sqrt(es2.cc*(2 - es2.cc)*es2.mueff) * yw

rank1  = es2.c1  * np.outer(pc, pc)
rankmu = es2.cmu * (y_sel.T * es2.w) @ y_sel
C_new  = (1 - es2.c1 - es2.cmu)*es2.C + rank1 + rankmu

print("hsig =", bool(hsig), "  p_c =", np.round(pc, 4))
print("\n(1-c1-cmu) * C  = 남기는 옛 정보 (%.1f%%)" % (100*(1 - es2.c1 - es2.cmu)))
print(np.round((1 - es2.c1 - es2.cmu)*es2.C, 4))
print("\nrank-one 기여 c1 * pc pc^T:")
print(np.round(rank1, 4))
print("\nrank-mu 기여 cmu * sum w_i y_i y_i^T:")
print(np.round(rankmu, 4))
print("\nC_new =")
print(np.round(C_new, 4))

d, B = np.linalg.eigh(C_new)
print("\n고유값 =", np.round(d, 4), " -> 축 길이 =", np.round(np.sqrt(d), 4))
print("조건수 = %.3f  (1이면 원, 클수록 길쭉한 타원)" % (d.max()/d.min()))
print("긴 축 방향 =", np.round(B[:, np.argmax(d)], 4))
hsig = True   p_c = [ 0.1136 -1.1408]

(1-c1-cmu) * C  = 남기는 옛 정보 (78.7%)
[[0.7873 0.    ]
 [0.     0.7873]]

rank-one 기여 c1 * pc pc^T:
[[ 0.002  -0.0201]
 [-0.0201  0.2015]]

rank-mu 기여 cmu * sum w_i y_i y_i^T:
[[ 0.0016 -0.0049]
 [-0.0049  0.0451]]

C_new =
[[ 0.7909 -0.0249]
 [-0.0249  1.0339]]

고유값 = [0.7884 1.0364]  -> 축 길이 = [0.8879 1.018 ]
조건수 = 1.315  (1이면 원, 클수록 길쭉한 타원)
긴 축 방향 = [-0.101   0.9949]

즉 한 세대의 C 갱신은 “기존 모양 84% 유지 + 장기 방향 16% 주입 + 이번 세대 성공 스텝 소량 반영” 의 가중 평균입니다. 한 번에 확 바뀌지 않기 때문에 노이즈가 있어도 안정적이지만, 수십~수백 세대가 쌓이면 골짜기 모양을 정확히 학습합니다.

(5) 100세대 뒤에는?

같은 계산이 반복되면서 타원이 어떻게 변해 가는지 숫자로 확인해 봅시다.

세대별 추적 코드
def rosen2(x):
    return 100*(x[0]**2 - x[1])**2 + (x[0] - 1)**2

tr = MiniCMA(np.array([-1.0, 1.5]), 0.4, seed=42)
rows = []
for g in range(1, 201):
    Xg = tr.ask(); fg = np.array([rosen2(x) for x in Xg]); tr.tell(Xg, fg)
    if g in (1, 2, 5, 10, 25, 50, 100, 200):
        d = np.linalg.eigvalsh(tr.C)
        rows.append((g, tr.counteval, fg.min(), tr.sigma,
                     np.sqrt(d.max()/d.min()), np.linalg.norm(tr.ps)))

print(f"{'gen':>4} {'evals':>6} {'f_best':>11} {'sigma':>9} {'축 비율':>8} {'||p_s||':>8}")
for r in rows:
    print(f"{r[0]:>4} {r[1]:>6} {r[2]:>11.3e} {r[3]:>9.2e} {r[4]:>8.2f} {r[5]:>8.3f}")
 gen  evals      f_best     sigma     축 비율  ||p_s||
   1      6   6.138e+00  3.79e-01     1.15    1.030
   2     12   5.213e+00  4.01e-01     1.38    1.489
   5     30   2.895e+00  3.60e-01     1.65    0.896
  10     60   8.605e-01  5.69e-01     2.25    1.247
  25    150   2.244e-01  2.28e-01     1.96    0.486
  50    300   4.636e-02  9.91e-01     5.21    2.809
 100    600   1.612e-08  2.47e-02    43.66    0.568
 200   1200   2.524e-25  6.70e-08    37.57    0.491

세 열만 보면 알고리즘의 전 생애가 보입니다.

  • 축 비율(장축/단축): 1에서 시작해 수십까지 커집니다 → 원이 골짜기 방향으로 길게 눕는 중.
  • \sigma: 초반엔 골짜기를 찾느라 유지·증가, 최적점 근처에서는 정밀도를 높이려 기하급수적으로 감소.
  • \|\mathbf{p}_\sigma\|: \chi_N \approx 1.3 근처를 오르내립니다. 이 값이 계속 크면 “더 크게 걸어라”, 작으면 “줄여라”의 신호.

(6) 확인 사살: 학습된 C 는 헤시안의 역행렬을 닮는다

이론적으로 CMA-ES가 수렴하면 C \propto H^{-1} (헤시안의 역) 에 가까워집니다. 즉 뉴턴법이 미분으로 얻는 정보를, CMA-ES는 함수값 비교만으로 근사한다는 뜻입니다. 잘 조건화되지 않은 이차함수로 확인해 보죠.

H = np.diag([1.0, 100.0, 10000.0])          # 조건수 10^4 인 이차함수
quad = lambda x: 0.5 * x @ H @ x

q = MiniCMA(np.ones(3), 1.0, seed=0)
q.optimize(quad, maxeval=20000, ftarget=1e-14)

C_norm    = q.C / np.trace(q.C)
Hinv_norm = np.linalg.inv(H) / np.trace(np.linalg.inv(H))
print("학습된 C (정규화) 대각:", np.round(np.diag(C_norm), 6))
print("H^-1     (정규화) 대각:", np.round(np.diag(Hinv_norm), 6))
print("\nC의 축 비율   = %.1f" % np.sqrt(np.linalg.cond(q.C)))
print("이론값 sqrt(cond(H)) = %.1f" % np.sqrt(np.linalg.cond(H)))
학습된 C (정규화) 대각: [9.95011e-01 4.90700e-03 8.20000e-05]
H^-1     (정규화) 대각: [9.90001e-01 9.90000e-03 9.90000e-05]

C의 축 비율   = 121.5
이론값 sqrt(cond(H)) = 100.0

대각 성분의 비율이 1 : 10^{-2} : 10^{-4} 로 H^{-1} 과 거의 같고, 축 비율도 이론값 100 근처(≈120)로 맞아떨어집니다. 미분을 한 번도 계산하지 않고, 오직 “누가 더 나은가”라는 비교만으로 곡률 정보를 복원한 셈입니다. CMA-ES를 “미분 없는 준-뉴턴법(derivative-free quasi-Newton)”이라고 부르는 이유예요.

3.4 세 알고리즘 비교

비교 그림 코드
ev = [t[0] for t in log]
fbest = np.minimum.accumulate([t[1] for t in log])

fig, ax = plt.subplots(figsize=(7, 4.2), dpi=110)
ax.semilogy(np.arange(1, len(h1) + 1), np.maximum(h1, 1e-16), label="(1+1)-ES")
lam2 = 4 + int(3 * np.log(4))
ax.semilogy(np.arange(1, len(h2) + 1) * lam2, np.maximum(h2, 1e-16), label="(μ/μ_w, λ)-ES")
ax.semilogy(ev, np.maximum(fbest, 1e-16), lw=2, label="CMA-ES (MiniCMA)")
ax.set_xlabel("function evaluations"); ax.set_ylabel("best $f$")
ax.grid(alpha=.3); ax.legend(); plt.show()
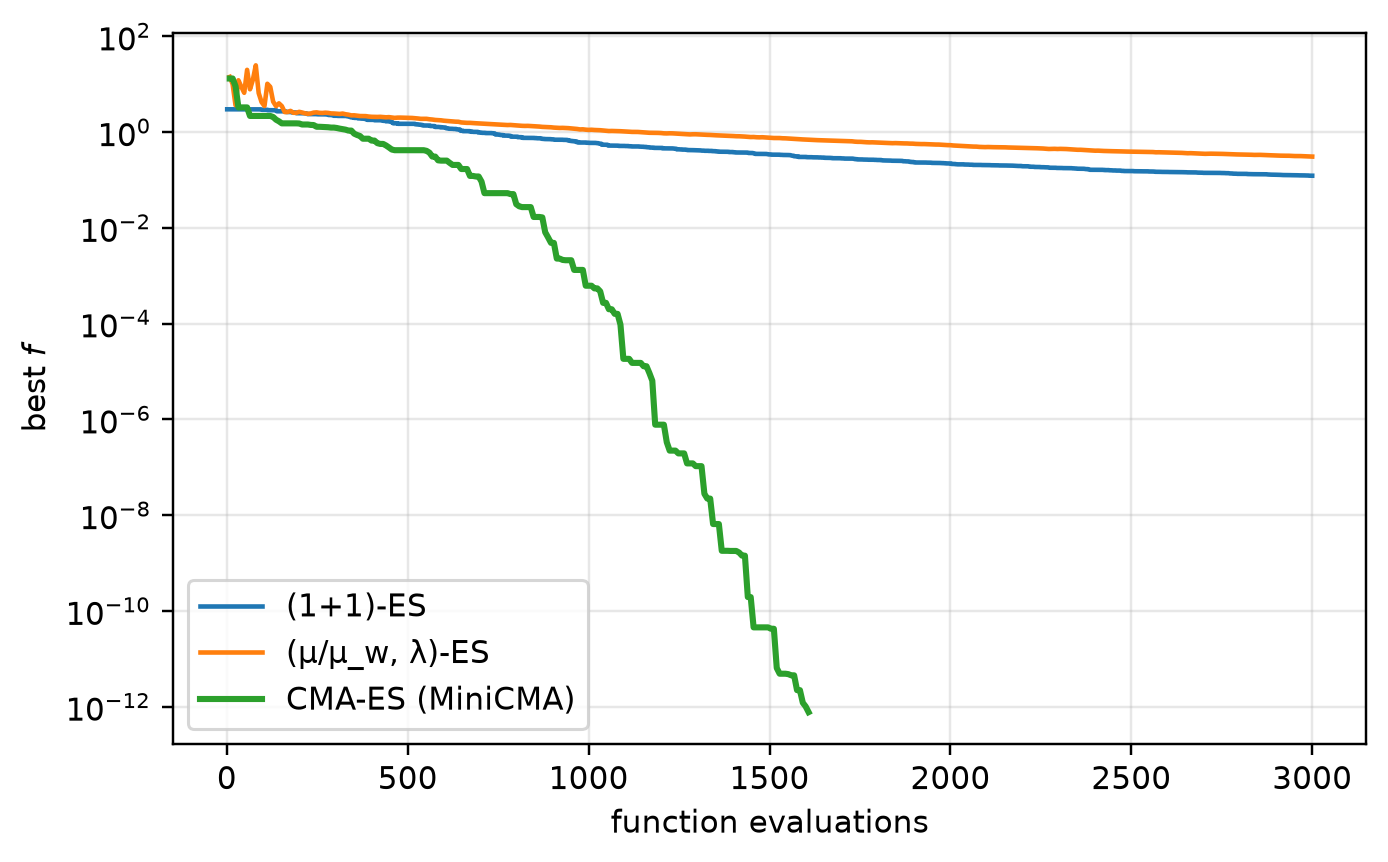
Figure 4: 같은 예산에서의 수렴 곡선. 세로축은 log 스케일입니다. CMA-ES만 기계 정밀도까지 내려갑니다.

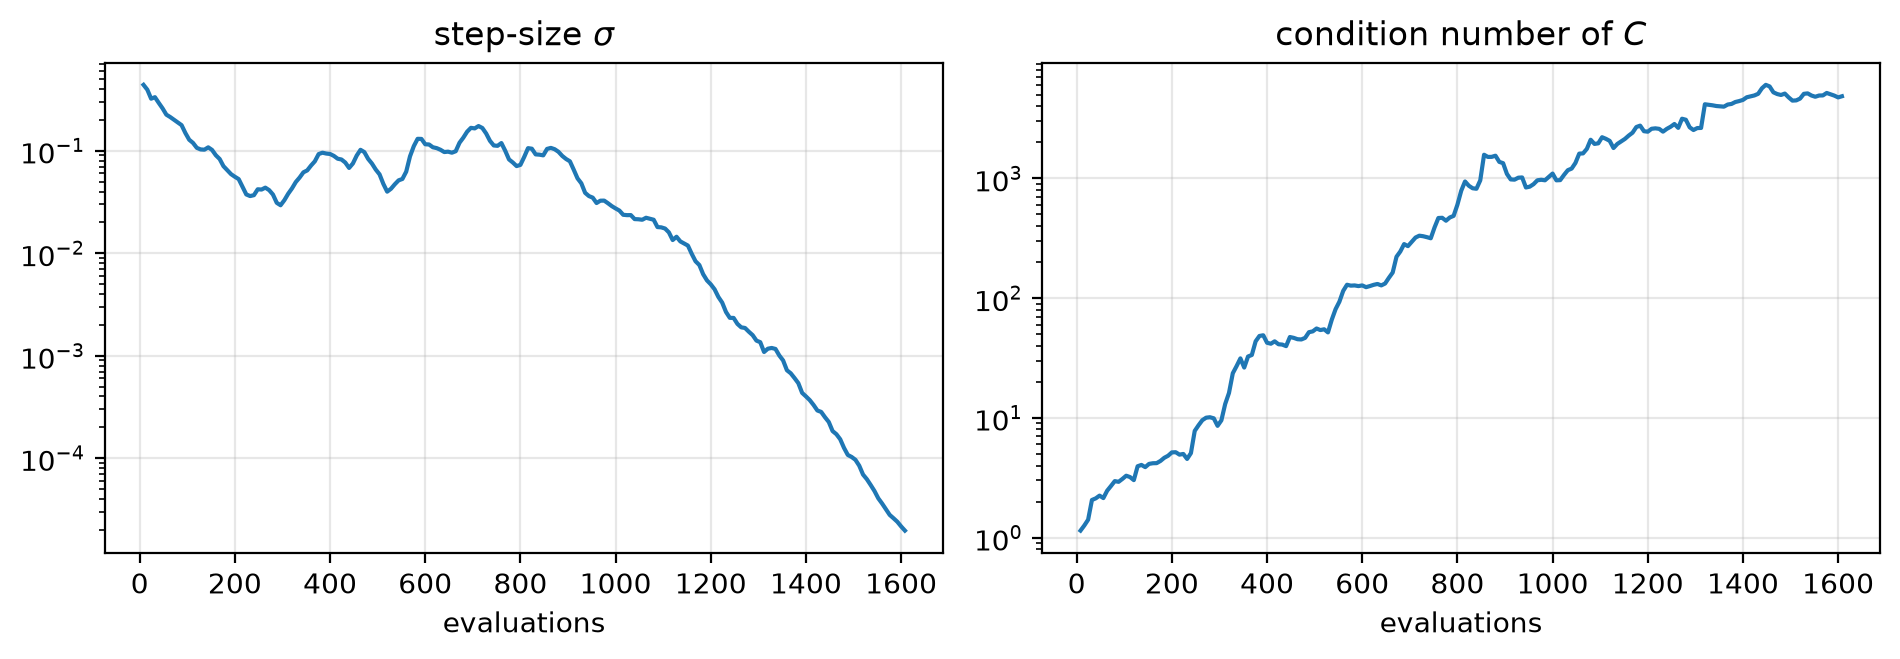
3.5 σ와 조건수는 어떻게 변했나

코드 보기
sig = [t[2] for t in log]
cond = [np.linalg.cond(t[4]) for t in log]

fig, ax = plt.subplots(1, 2, figsize=(9.6, 3.4), dpi=100)
ax[0].semilogy(ev, sig); ax[0].set_title("step-size $\\sigma$")
ax[1].semilogy(ev, cond); ax[1].set_title("condition number of $C$")
for a in ax:
    a.set_xlabel("evaluations"); a.grid(alpha=.3)
plt.tight_layout(); plt.show()
Figure 5: σ는 처음에 커졌다가 수렴하면서 기하급수적으로 줄고, C의 조건수는 골짜기 비율(≈100:1 이상)까지 자라납니다.

C 의 조건수가 커진다는 건 타원이 한쪽으로 길게 늘어났다는 뜻입니다. 알고리즘이 스스로 “이 방향으로는 크게 움직여도 된다”를 알아낸 것이죠. 위쪽 GIF에서 타원이 골짜기를 따라 눕는 장면이 바로 이 그래프입니다.


📦 4. 진짜 라이브러리: pycma

밑바닥 구현은 이해용이고, 실전에서는 pycma를 씁니다. 경계 제약, 재시작, 노이즈 처리, 로깅, 종료 조건 등이 다 들어 있습니다.

pip install cma
  • 한 줄로 쓰기
  • ask-and-tell
  • 자주 쓰는 옵션
  • 재시작 (IPOP)
import cma

xopt, es = cma.fmin2(cma.ff.rosen, 4 * [0], 0.5, {'verbose': -9, 'seed': 1})
print(np.round(xopt, 8), "f = %.2e" % cma.ff.rosen(xopt))
[1.00000001 1.00000002 1.00000004 1.00000008] f = 3.80e-15

fmin2(objective, x0, sigma0, options) — 초기점과 초기 보폭 \sigma_0 만 정하면 끝입니다.

es = cma.CMAEvolutionStrategy(4 * [0], 0.5, {'verbose': -9, 'seed': 1})
while not es.stop():
1    X = es.ask()
2    es.tell(X, [cma.ff.rosen(x) for x in X])
print("f* = %.2e, evals = %d" % (es.result.fbest, es.result.evaluations))
print("stop:", dict(es.stop()))
1
후보를 받아서
2
내가 원하는 방식으로 평가한 뒤 돌려줍니다 — 병렬 평가, 실기(hardware) 실험, 시뮬레이터 연동에 필수인 인터페이스입니다.
f* = 3.80e-15, evals = 1640
stop: {'tolfun': 1e-11}

이 구조 덕분에 “평가 1건에 5분 걸리는 시뮬레이션”도 X를 통째로 클러스터에 뿌렸다가 결과만 tell 하면 됩니다.

opts = {
    'bounds': [-2, 2],        # 상자 제약 (list of [lower, upper])
    'popsize': 16,            # lambda 직접 지정
    'tolfun': 1e-11,          # 함수값 변화 종료 조건
    'maxfevals': 5000,
    'CMA_diagonal': False,    # True면 대각 공분산만 (고차원에서 빠름)
    'verbose': -9, 'seed': 1,
}
xopt, es = cma.fmin2(cma.ff.rosen, 4 * [0], 0.3, opts)
print("bounded f* = %.2e" % cma.ff.rosen(xopt))

# 전체 옵션 목록이 궁금하면:
# cma.CMAOptions()  또는  cma.CMAOptions('tol')  로 검색
print([k for k in cma.CMAOptions().keys() if 'tol' in k][:8])
bounded f* = 5.07e-15
['tolconditioncov', 'tolfacupx', 'tolupsigma', 'tolflatfitness', 'tolfun', 'tolfunhist', 'tolfunrel', 'tolstagnation']

다봉(multi-modal) 함수에서는 한 번에 지역해에 빠집니다. 인구수를 2배씩 늘리며 재시작하는 IPOP-CMA-ES 가 표준 처방입니다.

xopt, es = cma.fmin2(cma.ff.rastrigin, 5 * [0.3], 0.3,
                     {'verbose': -9, 'seed': 3},
1                     restarts=6, incpopsize=2)
print("Rastrigin f* = %.3e" % cma.ff.rastrigin(xopt))
1
restarts 는 최대 재시작 횟수, incpopsize 는 재시작마다 곱해질 인구수 배율입니다.
Rastrigin f* = 0.000e+00

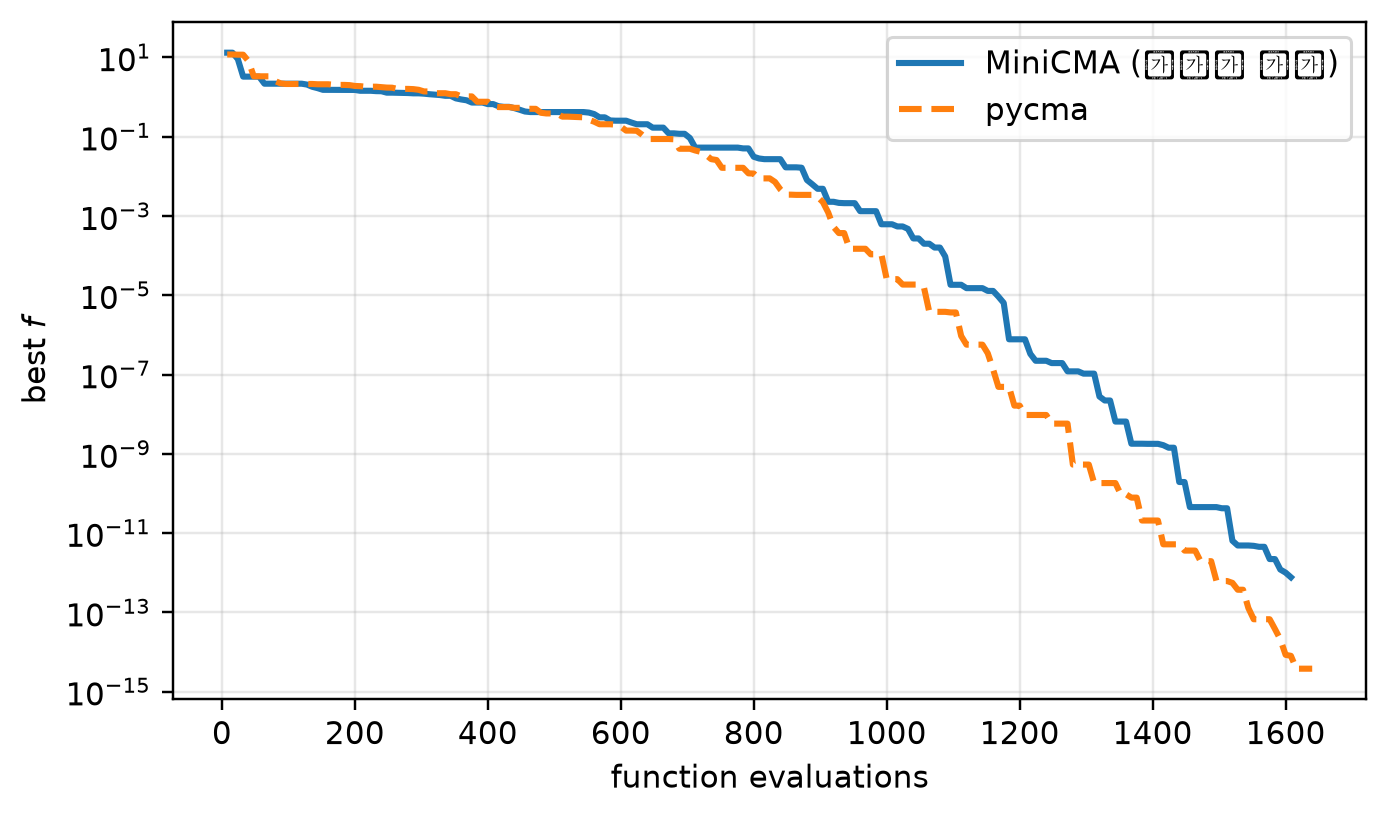
4.1 내 구현 vs pycma

코드 보기
es_p = cma.CMAEvolutionStrategy(4 * [0], 0.5, {'verbose': -9, 'seed': 1})
ev_p, f_p = [], []
while not es_p.stop():
    X = es_p.ask()
    fv = [cma.ff.rosen(x) for x in X]
    es_p.tell(X, fv)
    ev_p.append(es_p.countevals); f_p.append(es_p.result.fbest)

fig, ax = plt.subplots(figsize=(7, 4), dpi=110)
ax.semilogy(ev, np.maximum(fbest, 1e-16), lw=2, label="MiniCMA (밑바닥 구현)")
ax.semilogy(ev_p, np.maximum(f_p, 1e-16), "--", lw=2, label="pycma")
ax.set_xlabel("function evaluations"); ax.set_ylabel("best $f$")
ax.grid(alpha=.3); ax.legend(); plt.show()
Figure 6: MiniCMA와 pycma의 수렴 곡선. 뼈대가 같으니 궤적도 비슷합니다 — 차이는 대부분 안정성 장치와 종료 조건에서 옵니다.

4.2 단조 변환 불변성 확인

앞에서 말한 “등수만 쓴다”를 직접 검증해 봅시다.

def run(f, seed=7):
    """종료 조건까지 동일하게 만들기 위해 평가 횟수로만 끊는다."""
    opts = {'verbose': -9, 'seed': seed, 'maxfevals': 600,
            'tolfun': 0, 'tolfunhist': 0, 'tolx': 0, 'tolflatfitness': 10**9}
    es = cma.CMAEvolutionStrategy(4 * [0.1], 0.4, opts)
    es.optimize(f)
    return es.result.xbest

a = run(cma.ff.rosen)
b = run(lambda x: np.log(cma.ff.rosen(x) + 1e-30))   # 단조 증가 변환
c = run(lambda x: cma.ff.rosen(x) ** 3)              # 이것도 단조 증가

print("f     :", np.round(a, 8))
print("log f :", np.round(b, 8))
print("f^3   :", np.round(c, 8))
print("완전히 동일한가?", np.array_equal(a, b) and np.array_equal(a, c))
f     : [0.94105666 0.88417634 0.77034548 0.59164007]
log f : [0.94105666 0.88417634 0.77034548 0.59164007]
f^3   : [0.94105666 0.88417634 0.77034548 0.59164007]
완전히 동일한가? True

비트 단위까지 완전히 동일한 궤적이 나옵니다. 정렬 결과가 같으면 이후 계산이 전부 같기 때문이에요.

Warning단, 종료 조건은 불변이 아닙니다

위에서 tolfun 같은 함수값 기반 종료 조건을 일부러 꺼두었습니다. 켜 두면 f 와 f^3 은 “함수값 변화량”이 다르므로 서로 다른 시점에 멈춰 결과가 조금 달라집니다. 즉 탐색 자체는 불변, 멈추는 시점은 스케일에 의존합니다. 목적함수 스케일을 크게 바꿨다면 tolfun 도 같이 조정하세요.


🧭 5. 실전 감각

Tip하이퍼파라미터는 사실상 두 개뿐
  • x_0: 최적해가 있을 법한 곳. 모르면 정규화된 좌표계에서 중앙.
  • \sigma_0: 각 변수의 “탐색 반경”. 최적해가 x_0 \pm 3\sigma_0 안에 있도록 잡는 것이 경험칙입니다.

그래서 실무 팁: 모든 변수를 [0, 1] 로 정규화하고 x_0 = 0.5, \sigma_0 = 0.2\!\sim\!0.3 으로 시작하세요. 변수마다 스케일이 크게 다르면 CMA_stds 옵션으로 개별 지정할 수 있습니다.

상황 처방
차원 N \lesssim 100 기본 CMA-ES 그대로
N 이 수백~수천 'CMA_diagonal': True 또는 sep-CMA / LM-CMA 계열
지역해가 많다 restarts=9, incpopsize=2 (IPOP), 또는 BIPOP
평가에 노이즈가 있다 'noise_handling': True, 인구수 증가
평가가 매우 비싸다 (< 100회) 베이지안 최적화가 더 적합
미분을 쓸 수 있다 그냥 경사법을 쓰세요 — CMA-ES는 O(N^2) 의 값 평가가 필요합니다
CautionCMA-ES가 답이 아닌 경우

평가 예산이 수십 번뿐이거나, 변수가 대부분 이산/범주형이거나, 미분이 정확히 계산되는 문제라면 다른 도구가 낫습니다. CMA-ES의 스위트 스팟은 연속 변수 N \approx 3\sim100, 평가 10^3\sim10^5 회, 노이즈·불연속·비볼록이 섞인 블랙박스입니다.


🗂 6. 정리 & 코드

이 글에서 만든 스크립트는 pycma fork의 study/ 폴더에 정리해 두었습니다.

git clone -b study https://github.com/curieuxjy/pycma.git
cd pycma/study
python 01_random_search.py       # (1+1)-ES
python 02_mu_lambda_es.py        # (mu/mu_w, lambda)-ES
python 03_cmaes_from_scratch.py  # MiniCMA
python 04_pycma_basics.py        # pycma 사용법
python 05_visualize.py out.gif   # 애니메이션 생성

한 문장으로 요약하면 —

CMA-ES는 “다음에 어디를 뒤질까”를 정규분포 하나로 표현하고, 성공한 스텝들의 방향과 길이를 기억해 그 분포의 중심·크기·모양을 스스로 고쳐 나가는 알고리즘이다.
Reference

  • pycma (GitHub) · API 문서
  • The CMA Evolution Strategy: A Tutorial — N. Hansen (arXiv:1604.00772)
  • CMA-ES 공식 사이트
  • purecma.py — 300줄 남짓의 참조 구현
  • COCO/BBOB 벤치마크

Copyright 2026, JungYeon Lee