🧩AlphaNIST
글은 두 부분입니다. Part A는 원문 페이지의 그림과 영상을 페이지에 나오는 순서대로 하나씩 풀어 설명합니다. Part B는 “평행 그리퍼를 Allegro·LEAP·Shadow 같은 고자유도 다지 손으로 바꾸면 무엇이 달라지는가”를 따져 보는 필자 분석이고, 원문처럼 그림을 직접 만들어 붙였습니다. Part B의 그림은 전부 필자 제작 개념도이며 실험 결과가 아닙니다.
한 줄로 말하면
AlphaNIST는 Franka 팔과 두 손가락 그리퍼가 시뮬레이션 안에서 NIST 조립 보드의 20개 과제를 “다 조립했으면 1, 아니면 0”이라는 보상만으로 배우게 한 프로젝트입니다. 단계별 동작을 하나도 지정하지 않았는데, 다시 쥐기·보드에 대고 돌리기·손끝으로 톡톡 쳐서 너트 돌리기 같은 전략이 저절로 나왔습니다.
페이지 첫 문단은 이 생각을 AlphaGo와 AlphaZero에 빗댑니다. 📄 “AlphaZero learned from experience at scale, without human demonstrations. AlphaNIST brings this philosophy to contact-rich, high-precision robotic assembly in simulation.” 이름의 “Alpha”는 여기서 왔습니다.
이 철학을 실제로 굴러가게 만드는 장치는 네 가지입니다(🎙️ 0:15). 이진 과제 보상, 시뮬레이션에서 미리 만들어 둔 캐시된 시작 상태, 성공률이 50% 근처인 상태를 더 자주 연습시키는 Beta 샘플링, 그리고 최대 256,000개 병렬 환경입니다.
0. 원문 미디어 목록과 처리 방식
페이지에서 받은 미디어 전부입니다. 컨트롤러가 처음 건네준 목록에는 close-up 영상, timeline.json, Fig. 5 데이터 JSON이 빠져 있었는데, 실제 페이지에는 이 셋이 있고 해설에 가장 많이 쓰였습니다.
| 미디어 | 위치(페이지 순서) | 크기·길이 | 이 글에서의 처리 |
|---|---|---|---|
k10-strategies/selected-episodes-fixed.mp4 |
히어로, 10부품 조립 | 32.2 MB, 2:41, 1920×1080 50 fps | 링크 + 키프레임 스트립 2장 |
k10-strategies/selected-episodes-closeup.mp4 |
히어로, 위 영상과 동기화된 close-up 레이어 | 36.2 MB, 2:41, 736×736 | 키프레임 스트립에 사용 |
k10-strategies/timeline.json |
히어로 영상의 “장면 바로가기” 데이터 | 1.9 KB | 표로 옮김 |
research/nist-board-orbit.gif |
조립 과제 | 13.2 MB, 200프레임 10초 | mp4로 변환(0.2 MB)해 임베드 |
research/k1-starting-states.mp4 |
학습 방법: 시작 상태 | 2.7 MB, 0:34 | 원 URL을 <video>로 임베드 + 스트립 |
research/sgs-method-light.gif |
학습 방법: success-guided sampling | 24.5 MB, 859프레임 30초 | mp4로 변환(0.57 MB)해 임베드 + 단계 스트립 |
assembly-demo.mp4 |
단일 부품 실험 | 62.1 MB, 1:43, 3840×1080 25 fps | 링크 + 20과제 그리드 |
research/heterogeneous-training-light.svg |
Fig. 5 | 78.6 KB | PNG로 래스터화 |
research/heterogeneous-training-data.json |
Fig. 5의 원자료(페이지가 링크하지는 않음) | 150 KB | 표로 옮김 |
peg-regrasp.png 외 assembly-strategies/*.png 7장 |
emergent 행동 갤러리 | 각 3840×1440 | 1600×600 JPEG로 축소해 전부 삽입 |
overview.mp4 |
히어로의 “Narrated overview · 4:36” 링크 | 43.3 MB, 4:36, 음성 있음, 자막 트랙 없음 | 링크 + 내레이션 전사 + 장면 스트립 3장 |
큰 영상(25 MB 이상)은 블로그 레포에 넣지 않고 원 URL로 링크만 걸었습니다. 대신 영상을 OpenCV로 처음부터 끝까지 순차 디코딩해 장면 전환 시점을 찾고, 그 시점의 프레임을 뽑아 스트립으로 붙였습니다. overview 영상은 자막 트랙이 없어서 오디오를 뽑아 Whisper(medium.en)로 받아 적었습니다. 자동 전사이므로 단어 단위 오류가 있을 수 있지만, 수치는 모두 화면의 슬라이드 문구와 대조했습니다.
1. 페이지에 있는 것과 없는 것
리뷰를 읽기 전에 사실관계부터 정리합니다. 아래 표의 “근거” 열에 없는 것은 쓰지 않았습니다.
| 항목 | 내용 | 근거 |
|---|---|---|
| 로봇 팔 | Franka (Panda 외형) | 📄 og:image:alt “A Franka robot assembling components on the NIST board in simulation.” + 모든 영상의 외형 |
| 엔드 이펙터 | 두 손가락 평행 그리퍼 | 📄 “A two-finger gripper may also need solutions quite different…” |
| 과제 | NIST Assembly Task Board #1의 20개 과제, 가장 작은 부품 4 mm | 📄 본문, Fig. 5 축 라벨 |
| 보상 | 이진 과제 보상: 조립 완료 1, 아니면 0. 도달·파지·부분 삽입에 대한 진행 보상 없음 | 🎙️ 0:24~0:34 |
| 관측 | point cloud + 로봇 상태 | 🎙️ 1:31 “It takes point clouds and robot state as input” |
| 시연 데이터 | 사용 안 함. 캐시는 “시작 상태”이지 시연이 아님 | 📄 “The cache supplies starting states, not demonstrations.” |
| 학습 규모 | 최대 256K 병렬 환경, GPU당 4K 환경, 슬라이드 표기 64 GPUs × 4K | 🎙️ 1:14, 슬라이드 1:24 |
| 학습 알고리즘 | 페이지에 명시 없음. 강화학습이라는 것만 분명함 | (관련 SGS 논문은 PPO) |
| 시뮬레이터 | 페이지에 명시 없음 | |
| 행동 공간·제어 방식 | 페이지에 명시 없음 | |
| sim2real | 페이지에 명시 없음. 모든 영상과 수치가 시뮬레이션 | 📄 “in simulation” 반복 |
| 저자·소속 | 페이지에 없음 | |
| 논문·코드 | 공개 안 됨. SVG 메타데이터가 “paper Figure 5”를 언급 | 📊 SVG <dc:description> |
관련 프로젝트 SGS: Beta 샘플링 그림의 캡션 옆에 SGS project ↗ 링크가 있습니다. SGS는 “A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control”(arXiv:2610.12465, CoRL 2026, University of Washington·NVIDIA)입니다. 같은 NIST 보드, 같은 Franka, 같은 샘플링 아이디어를 쓰지만 과제마다 정책을 따로 학습합니다. AlphaNIST 페이지가 SGS와 같은 팀인지는 페이지만으로는 알 수 없습니다. 이 글에서는 AlphaNIST 페이지가 설명하지 않는 Beta 샘플링의 정의를 확인할 때만 SGS 논문을 빌려 쓰고, 그때마다 🔗로 표시합니다.
Part A. 원문 해설
페이지 순서를 그대로 따라갑니다. 히어로(10부품 영상) → 조립 과제(보드) → 아이디어 → 학습 방법 두 가지(시작 상태, 샘플링) → 단일 부품 실험(20과제 영상, Fig. 5) → emergent 행동 갤러리 순이고, 마지막에 별도 링크로 걸린 내레이션 영상을 해설합니다.
A1. 히어로: 10부품을 한 번에 조립하는 영상
페이지를 열면 가장 먼저 나오는 것이 10개 부품을 연달아 조립하는 2분 41초짜리 영상입니다(영상 열기, 32 MB). 캡션은 “Ten-component assembly.” 한 줄이고, 그 아래 설명이 중요합니다.
📄 “Four successful ten-part runs, using a policy trained separately from the single-component policy below.”
즉 이 영상의 정책은 아래 단일 부품 실험의 정책과 다른 정책입니다. 내레이션은 10부품 설정에서 보상이 바뀐다고 말합니다. 🎙️ “Now the binary task reward arrives only when all active parts are assembled. There are many possible orders and the policy has to choose.” 부품 하나를 끼울 때마다 보상을 주지 않고, 10개가 전부 끝나야 1입니다. 조립 순서도 정해 주지 않습니다.
영상은 성공한 에피소드 4개를 이어 붙인 것입니다. 장면 전환을 프레임 차이로 찾아보면 0:00, 0:45.74, 1:30.24, 2:12.74에서 정확히 끊기고, 이것은 timeline.json의 start_s 값과 일치합니다.
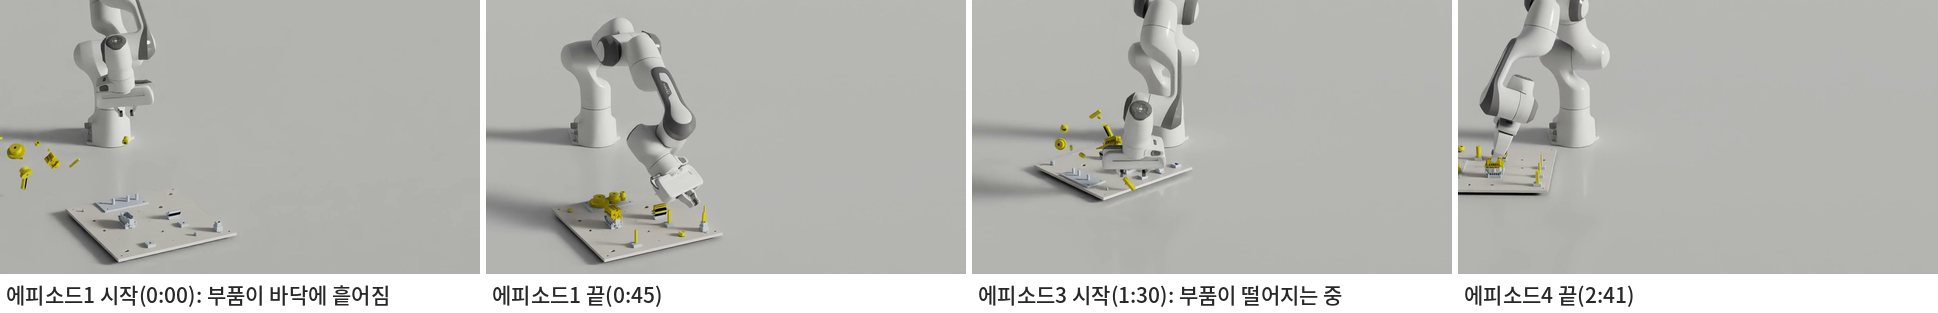
10부품 영상의 에피소드 경계(wide 뷰에서 필자가 추출). 왼쪽부터 에피소드 1의 첫 프레임에서는 노란 부품들이 보드 옆 바닥에 흩어져 있고, 끝 프레임에서는 보드에 꽂혀 있습니다. 세 번째 칸(1:30.3)에서는 부품이 공중에서 떨어지는 중이어서, 에피소드가 부품을 무작위로 떨어뜨려 흩어 놓는 것으로 시작한다는 것을 알 수 있습니다.
페이지는 이 영상 위에 close-up 레이어(selected-episodes-closeup.mp4, 736×736)를 겹쳐서 재생합니다. main.js를 보면 close-up 영상의 재생 시각을 고정 뷰 영상에 60 ms 이내로 맞추는 동기화 코드가 있고, “Close-up” 스위치로 켜고 끌 수 있습니다. 또 timeline.json을 읽어서 “장면 바로가기” 버튼을 만듭니다. 그 데이터가 저자가 직접 붙인 장면 설명이라서 표로 옮깁니다.
| 에피소드 | 시작 | 길이 | 저자 라벨(시각) | 페이지 버튼 그룹 |
|---|---|---|---|---|
| 1 | 0:00 | 45.7 s | Prehensile maneuver (0:03), Long-range threading (0:09), Long-range insertion (0:31), Check assembly completion (patrolling) (0:43) | Long-range manipulation (마지막 라벨은 버튼에서 제외) |
| 2 | 0:45.7 | 44.5 s | 라벨 없음 | |
| 3 | 1:30.2 | 42.5 s | Throw / toss object away (1:31), Grasp failure (1:34), Toss object away (1:41) | Moving objects aside, Recovery |
| 4 | 2:12.7 | 28.3 s | Toss object away (2:15), Toss object away (2:20) | Moving objects aside |
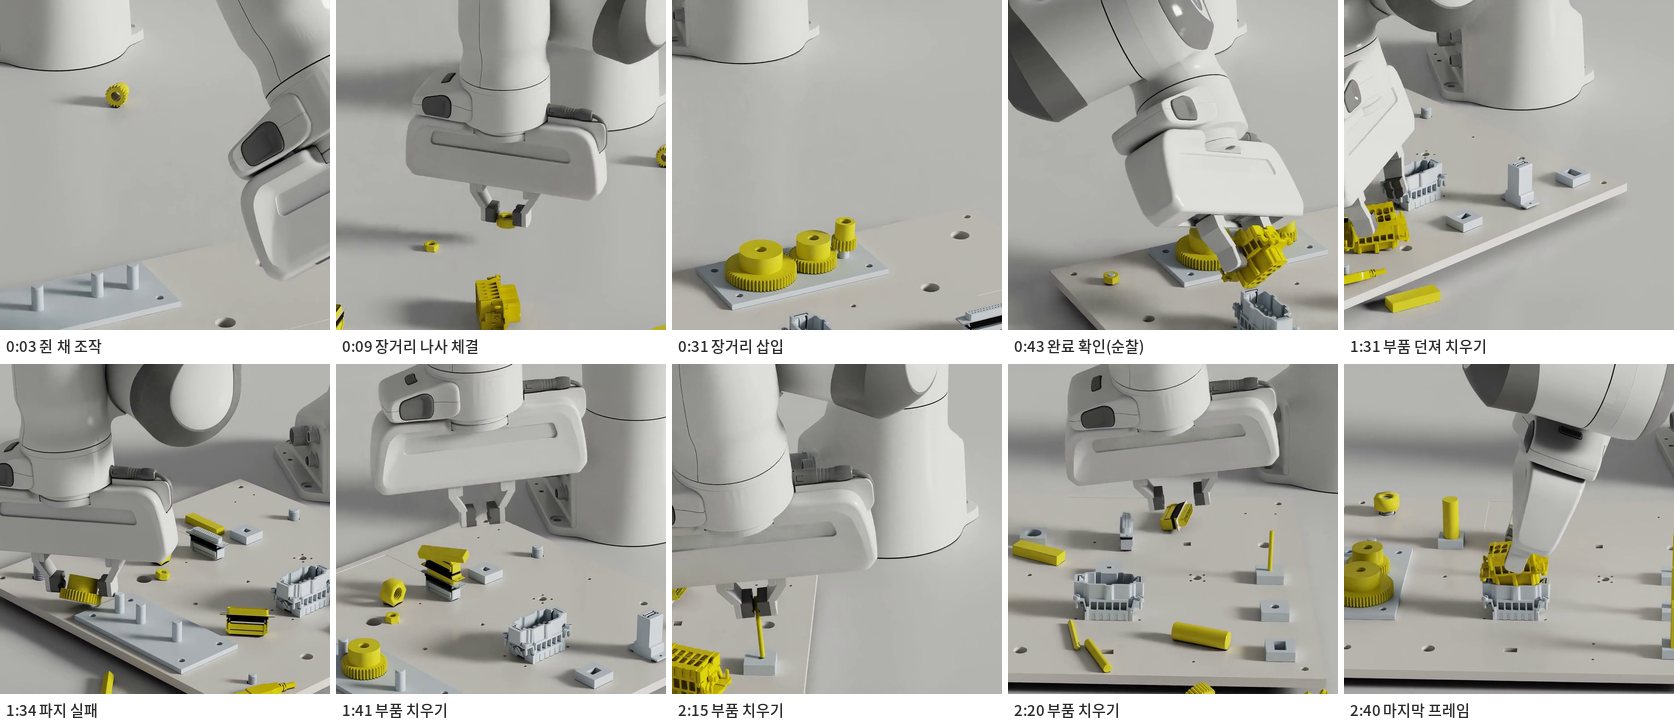
저자 라벨 시각의 close-up 프레임(필자 추출, 라벨은 timeline.json을 번역). 0:03에는 그리퍼가 기어를 쥔 채 움직이고, 0:09에는 너트를 집어 먼 쪽 볼트로 옮깁니다. 0:43의 “순찰”은 조립을 끝낸 뒤 보드 위를 훑는 동작입니다. 1:31·2:15·2:20은 방해가 되는 부품을 밀거나 던져 치우는 장면이고, 1:34는 파지에 실패했다가 다시 시도하는 장면입니다. 한 프레임만으로는 동작이 잘 안 보이는 칸도 있으니 원 영상과 함께 보는 것이 좋습니다.
이 라벨에서 눈여겨볼 점이 두 가지입니다.
- “던져서 치우기”가 세 번 나옵니다. 다음에 쓸 소켓 위에 다른 부품이 있으면 정책은 그것을 집어서 옆으로 던지거나 밉니다. 보상에는 “깔끔하게 정리하라”는 항이 없으니, 부품을 보드 밖으로 던지는 것이 손해가 아니라면 정책은 그렇게 합니다. 실제 로봇에서는 바람직하지 않을 수 있는 행동입니다(✍️ 필자).
- “Check assembly completion (patrolling)”: 조립을 다 끝낸 뒤 보드를 한 번 훑는 동작에 저자가 “순찰”이라는 이름을 붙였습니다. 보상이 “모든 부품이 조립됐을 때”에만 오므로, 정책이 마지막 확인 동작을 학습했다고 읽을 수 있습니다. 다만 이것이 실제로 상태를 확인하는 기능을 하는지, 에피소드 끝까지 남는 시간 동안의 버릇인지는 페이지만으로 판단할 수 없습니다.
A2. 조립 과제: NIST Assembly Task Board #1
NIST Assembly Task Board #1, 완전 조립 상태(원문 nist-board-orbit.gif를 mp4로 변환, 10초 루프). 회색은 보드에 고정된 부분, 노란색은 로봇이 옮겨 끼워야 하는 부품입니다. 카메라가 보드 둘레를 몇 도 정도만 천천히 돌기 때문에 원근 차이로 부품의 높이를 가늠할 수 있습니다.
이 GIF가 보여 주는 것은 목표 상태 하나입니다. 앞쪽에 크기가 다른 기어 3개가 맞물려 있고, 가운데에 커넥터들(검은 줄무늬의 방수 커넥터, D-sub, USB, BNC, RJ45), 뒤쪽과 양옆에 높이가 다른 노란 막대(로드·페그)와 너트가 꽂혀 있습니다.
📄 페이지 설명은 짧지만 과제가 왜 어려운지 정확히 짚습니다.
“The NIST board has twenty assembly tasks, with parts as small as 4 mm. Fitting one part can take several changes of grasp and orientation. Tight clearances leave little room for error: a tilted nut can jam or cross-thread.”
“With several parts, the robot also has to choose an order. An installed component may block the gripper’s next move.”
20개 과제는 Fig. 5의 축 라벨과 데이터 JSON의 asset_order로 정확히 알 수 있습니다.
| 계열 | 과제(그림 라벨) | 데이터 이름 |
|---|---|---|
| 너트 체결 | N4, N8, N12, N16 | nut_thread_m4 ~ m16 |
| 기어 맞물림 | Gs, Gm, Gl | gear_mesh_small/medium/large |
| 로드 삽입 | R4, R8, R12, R16 | rod_insert_4mm ~ 16mm |
| 페그 삽입 | P4, P8, P12, P16 | peg_insert_4mm ~ 16mm |
| 커넥터 | USB, WP, BNC, DS, RJ | usba, waterproof, bnc, dsub, rj45 |
A3. “로봇은 창의적일 수 있다, 여지를 준다면”
페이지의 중간 제목은 “Robots can be creative—if we give them room.” 입니다. 이 절은 그림 없이 두 문단으로 주장만 펼칩니다.
- 동작을 하나하나 지정하려면 접촉과 장애물이 바뀔 때마다 로봇이 어떻게 반응해야 하는지를 미리 다 예상해야 합니다.
- 📄 “A two-finger gripper may also need solutions quite different from those that come naturally to a human hand.” 두 손가락 그리퍼에 맞는 해법은 사람 손에게 자연스러운 해법과 다를 수 있다는 것입니다.
- 그러니 성공에만 이진 보상을 주고, 대량의 다양한 경험으로 학습시켜 사람이 가르칠 생각을 못 한 해법을 로봇이 찾을 여지를 남기자는 것입니다.
2번 문장은 Part B에서 다시 쓰입니다. 그리퍼를 사람 손과 비슷한 다지 손으로 바꾸면 이 논리의 무게가 달라지기 때문입니다.
A4. 학습 방법 ①: 경험의 다양성, 이질적인 asset과 시작 상태
📄 “One policy trains across twenty heterogeneous assemblies, starting from loose parts, in-hand grasps, and partial assemblies cached in simulation. Near-complete starts let the robot practice finishing an assembly before it can solve the whole task. The cache supplies starting states, not demonstrations.”
원문 영상 "Examples of diverse training starting states"(0:34, 원 URL에서 재생). 페이지의 접근성 라벨은 "Sampled single-component starting states, held briefly without policy actions"입니다.
이 영상은 시작 상태를 1.2초씩 28개 보여 줍니다(33.6초 ÷ 1.2초 = 28, 프레임 차이로 확인). 접근성 라벨대로 정책이 아무 행동도 하지 않은 채 상태를 잠깐 유지하는 장면이라, 화면 안에서 아무것도 움직이지 않습니다. 각 상태의 가운데 프레임을 확대해 보면 세 가지 유형이 섞여 있습니다.
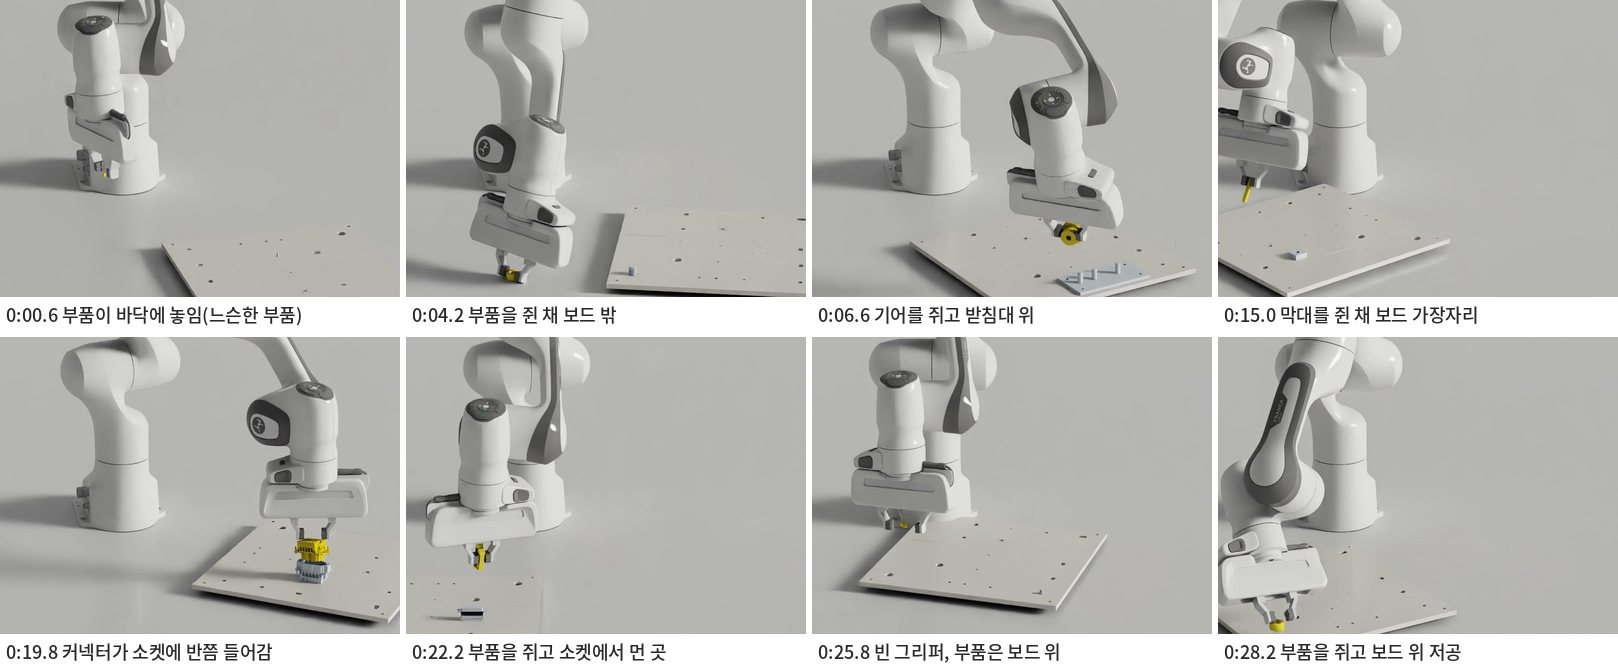
28개 시작 상태 중 8개(필자 추출, 라벨은 필자가 화면을 보고 붙인 설명). 부품이 바닥에 놓인 상태, 그리퍼가 부품을 이미 쥔 상태, 커넥터가 소켓에 반쯤 들어간 상태가 섞여 있습니다. 매 상태마다 보드의 위치와 방향, 팔의 자세가 달라진다는 점도 눈에 띕니다. 보드는 탁자가 아니라 바닥에 놓여 있습니다.
📊 Fig. 5의 데이터 JSON에는 이 시작 상태들이 실제로 어떤 이름의 층위(stratum)로 나뉘는지가 드러나 있습니다. “따로 학습한 dense 보상 정책”의 성공률을 층위별로 기록한 지표 이름이 grasp_asset_in_air, start_fully_assembled, start_assembled, start_grasped_then_assembled 네 가지이고, 별도로 sparse_start_random_success_rate(무작위 시작 성공률)라는 필드가 있습니다. 이름으로 보아 공중에서 쥔 상태, 조립 완료 직전 상태, 부분 조립 상태, 쥔 뒤 조립된 상태, 무작위(느슨한 부품) 상태로 보입니다. 다만 각 층위의 정확한 정의는 페이지에 없으니 이름에서 읽은 해석입니다.
🎙️ 내레이션은 왜 이런 은행(bank)이 필요한지를 한 문장으로 말합니다. “From loose parts alone, an untrained policy may rarely reach insertion.” 이진 보상만 있으면, 부품이 바닥에 흩어진 상태에서 시작한 무작위 정책이 우연히 삽입까지 성공할 확률은 거의 0이고, 성공을 한 번도 못 보면 학습 신호도 없습니다. 그래서 끝에 가까운 상태에서 시작시켜 “마무리”부터 연습하게 합니다. 역방향 커리큘럼과 같은 발상입니다.
A5. 학습 방법 ②: Success-guided sampling
📄 “Beta sampling favors starting states the policy solves about half the time, while giving every state a chance. Progress on one state can make another solvable; its sampling weight then changes with new outcomes.”
원문 애니메이션 "Starting states receive different amounts of practice as the policy learns."(sgs-method-light.gif 24.5 MB를 mp4 0.57 MB로 변환, 30초)
이 애니메이션은 30초 동안 같은 4단계 루프를 세 번 돕니다. 화면 요소를 하나씩 읽으면 다음과 같습니다.
- 왼쪽 격자 “Starting states”: 8×8 = 64칸이 시작 상태 64개입니다. 칸의 색이 그 상태의 성공률이고, 왼쪽 세로 막대가 범례입니다(0은 거의 흰색, 1은 진한 올리브색).
- 오른쪽 반원 “Sampling weight”: 가로축이 성공률 0~1, 세로축이 샘플링 가중치입니다. 점 하나하나가 시작 상태이고, 점은 자기 성공률에 해당하는 곡선 위치에 놓입니다. 곡선 꼭대기에 “50%”가 표시돼 있습니다.
- 아래 “Data → Train → Policy”: 학습 루프의 데이터 흐름입니다.
- 위쪽 점 4개와 단계 이름: 지금 몇 번째 단계인지를 표시합니다.
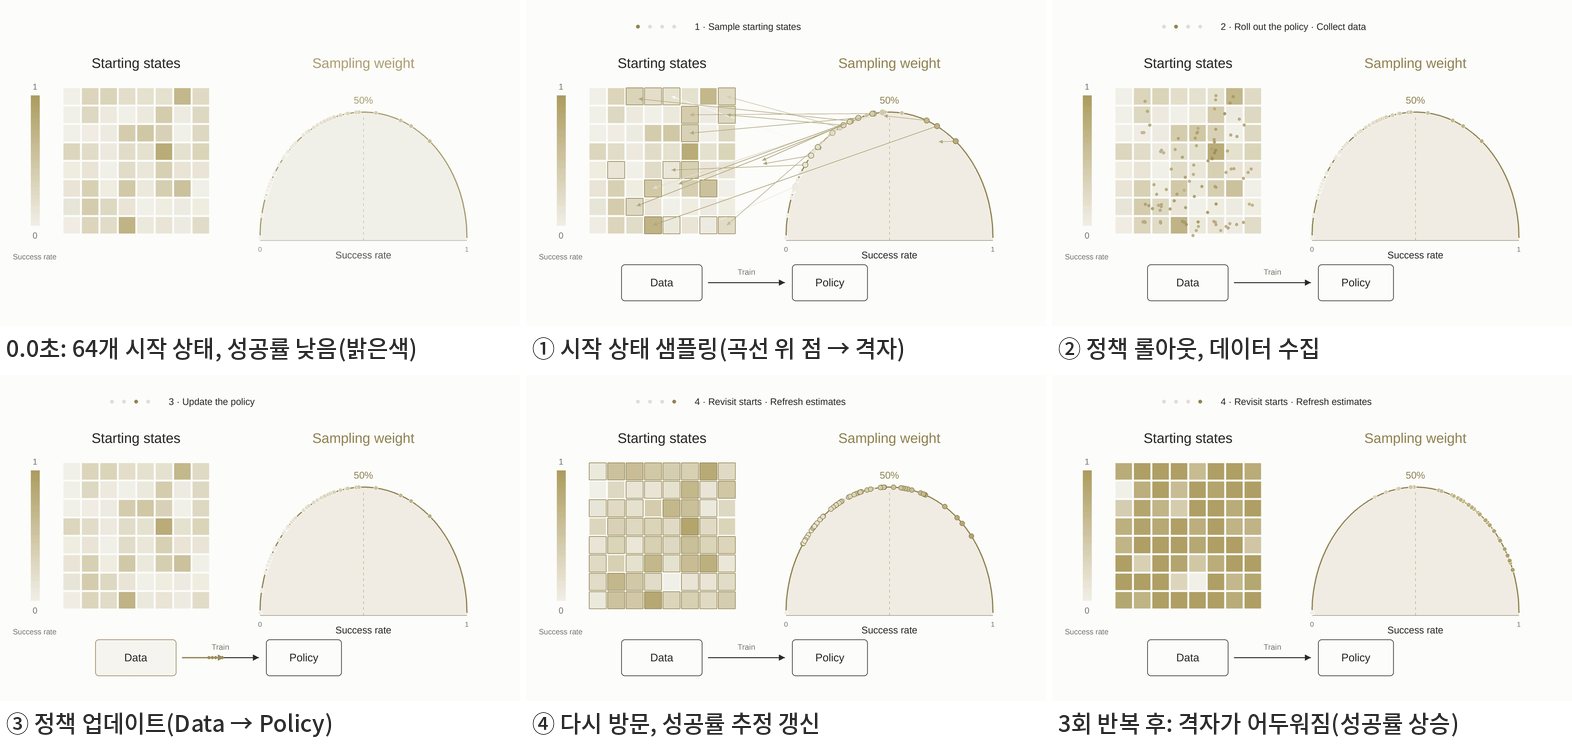
원문 애니메이션의 단계별 프레임(필자 추출). ① 곡선 위 점에서 격자로 화살표가 그어지며 시작 상태가 뽑힙니다. 화살표는 곡선 꼭대기(50%) 근처 점에서 많이 나가고, 양끝 점에서는 드물게 나갑니다. ② 뽑힌 칸에서 작은 점(경험)이 흩어져 Data 상자로 모입니다. ③ Data에서 Policy로 화살표가 이동하며 정책이 갱신됩니다. ④ 격자 칸 색이 바뀌고 곡선 위 점이 새 성공률 위치로 옮겨 갑니다. 세 번째 바퀴가 끝나면 격자 대부분이 진해져 있습니다.
애니메이션이 말하는 것은 두 가지입니다. 첫째, 곡선 꼭대기 근처(성공률 50% 안팎) 상태가 가장 많이 뽑힌다. 둘째, 아직 거의 못 푸는 상태(왼쪽 끝)와 이미 다 푸는 상태(오른쪽 끝)도 가끔은 뽑힌다. 4단계에서 성공률이 갱신되면 같은 상태라도 곡선 위 위치가 바뀌고, 따라서 다음 바퀴의 연습량이 달라집니다.
가중치의 정확한 식. 페이지 본문에는 식이 없지만, 🎙️ overview 영상 1:00~1:14의 슬라이드에 식이 적혀 있습니다.
w(p) \;=\; \epsilon + \sqrt{p\,(1-p)}
p는 “그 시작 상태에서의 최근 성공률”입니다. \sqrt{p(1-p)}는 성공 확률이 p인 베르누이 시행의 표준편차이고, p=0.5에서 최대값 0.5가 됩니다. 그래프로 그리면 정확히 반원이라서 원문 애니메이션의 오른쪽 곡선이 반원 모양입니다. \epsilon은 양끝(p=0, p=1)에서도 가중치가 0이 되지 않게 하는 바닥값입니다. 결과가 가장 불확실한 상태, 즉 학습 신호가 가장 많은 상태를 가장 자주 연습시키는 셈입니다.
“Beta”라는 이름은 🔗 SGS 논문 식 (1)에서 설명됩니다. SGS는 목표 성공률 t와 집중도 \kappa로 매개화한 Beta 모양 커널을 씁니다.
w_i = (p_i+\epsilon)^{\kappa t}\,(1-p_i+\epsilon)^{\kappa(1-t)}, \qquad \ell_i=\log(w_i+\epsilon)
SGS가 조작 과제에 쓴 값이 t=0.5, \kappa=1, \epsilon=10^{-4}입니다. 대입하면 w_i=\sqrt{(p_i+\epsilon)(1-p_i+\epsilon)}\approx\sqrt{p_i(1-p_i)}가 되어 AlphaNIST 슬라이드의 식과 같은 꼴이 됩니다. 즉 Beta(1.5, 1.5) 분포의 밀도 모양을 가중치로 쓰는 것입니다.
⚠️ 식과 실제 샘플링 확률은 다를 수 있습니다. 🔗 SGS는 \ell_i에 온도 T=2인 softmax를 씌워 다음 시작 상태를 뽑습니다. softmax(\log w / T)는 w^{1/T}에 비례하므로 실제 확률은 w^{1/2}, 대략 (p(1-p))^{1/4}에 비례하고, 슬라이드의 반원보다 훨씬 평평합니다. AlphaNIST가 같은 온도를 쓰는지는 페이지에 없습니다. 슬라이드의 식이 “가중치”라고만 적혀 있으므로, 샘플링 확률이 정확히 그 식에 비례한다고 단정하면 안 됩니다. 🔗 SGS는 각 상태의 성공률 p_i를 최근 H=100번의 성공/실패 평균으로 추정한다는 점도 밝힙니다. 이 숫자는 Part B에서 다시 씁니다.
A6. 단일 부품 실험: 정책 하나가 20과제를 모두
페이지의 실험 절 첫 영상입니다(영상 열기, 62 MB). 3840×1080 화면의 왼쪽은 고정 카메라, 오른쪽은 같은 시각의 close-up입니다. 캡션은 📄 “One policy performs all twenty assembly tasks, with one component to assemble in each run.”
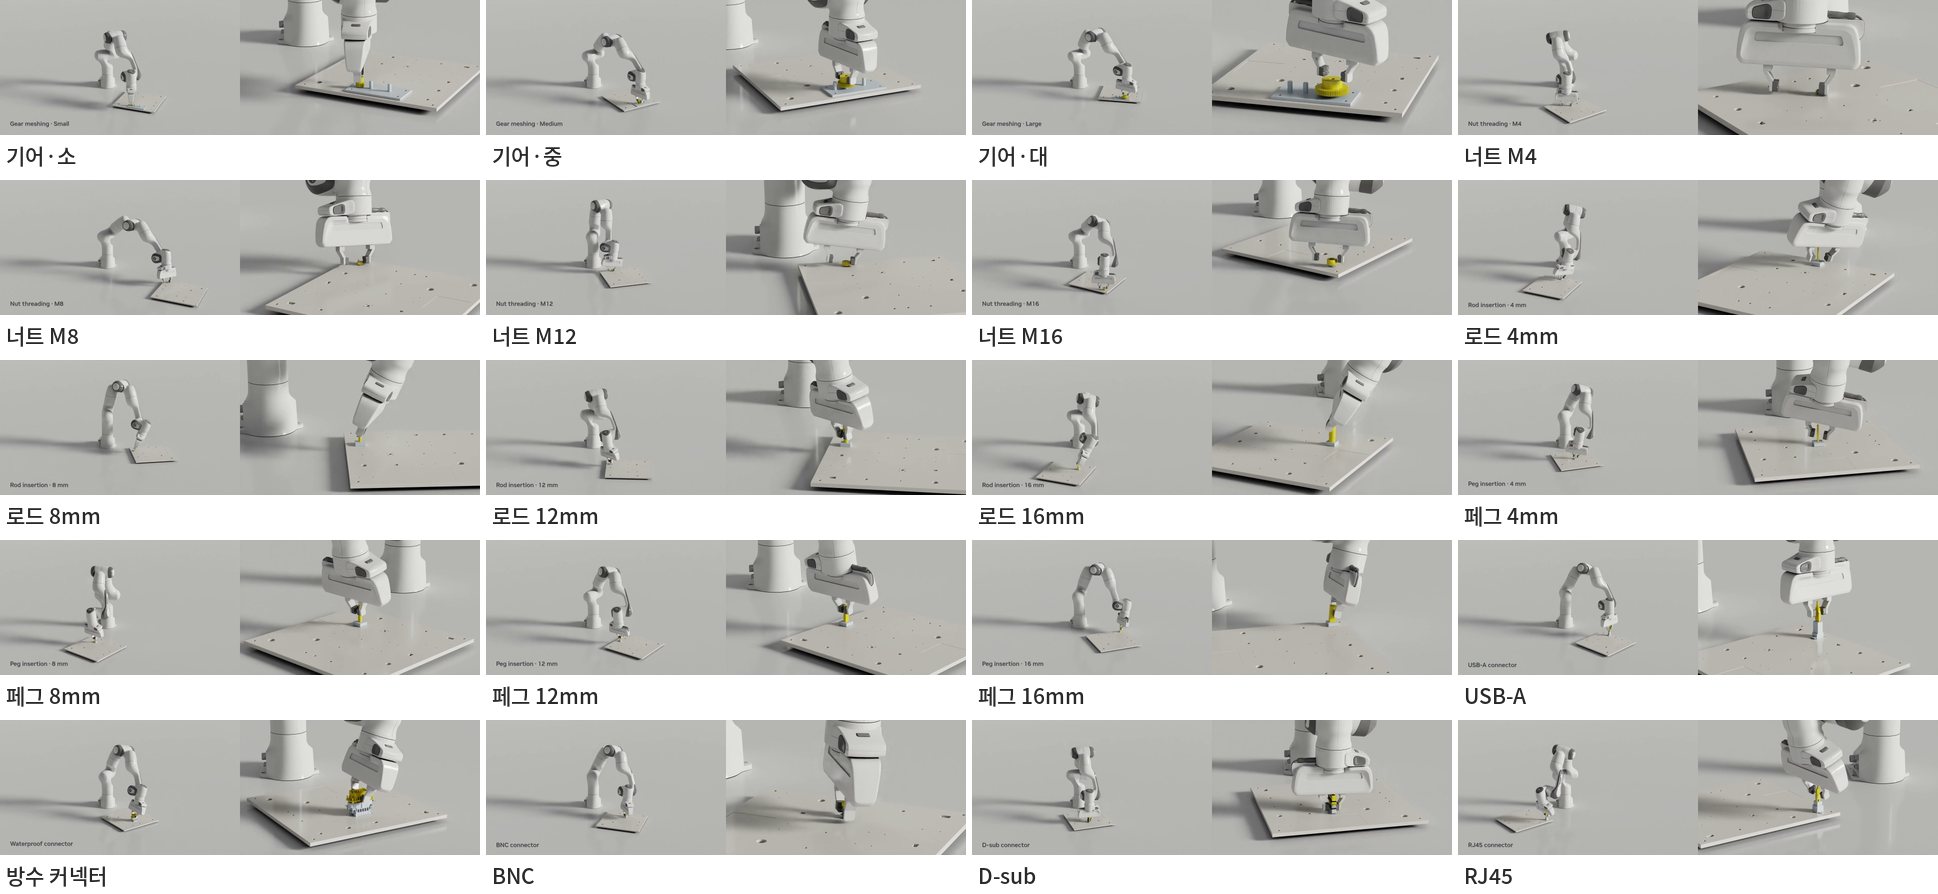
20개 클립 각각의 마지막 프레임(필자 추출, 클립 경계는 프레임 차이로 검출). 각 칸의 왼쪽 반은 고정 뷰, 오른쪽 반은 close-up이고, 영상 왼쪽 아래에 과제명이 표시됩니다. 20개 클립 모두 부품이 보드 밖 바닥이나 보드 가장자리에 놓인 상태에서 시작해 마지막 프레임에서 조립이 끝나 있습니다.
페이지는 이 영상에 장(chapter) 버튼 5개를 붙입니다(data-start 값). 필자가 검출한 클립 경계와 함께 정리하면 다음과 같습니다.
| 장 | 시작 | 클립(과제 순서) | 클립 길이(초) |
|---|---|---|---|
| Gears | 0:00 | 소 · 중 · 대 | 4.1 · 4.0 · 2.7 |
| Nuts | 0:10.76 | M4 · M8 · M12 · M16 | 10.2 · 7.1 · 7.1 · 8.6 |
| Rods | 0:43.64 | 4 · 8 · 12 · 16 mm | 5.4 · 2.5 · 2.2 · 3.4 |
| Pegs | 0:57.16 | 4 · 8 · 12 · 16 mm | 4.4 · 2.8 · 3.2 · 6.1 |
| Connectors | 1:13.68 | USB-A · 방수 · BNC · D-sub · RJ45 | 4.4 · 6.4 · 9.8 · 3.0 · 6.2 |
클립 길이는 편집된 영상의 길이이지 과제 수행 시간이 아닙니다. 재생 속도(1배속인지)가 페이지에 없기 때문입니다. 그래도 계열 안에서 상대적인 경향은 읽힙니다. 너트는 회전이 필요해서 길고, 가장 작은 M4가 가장 깁니다. 커넥터 중에서는 BNC가 9.8초로 가장 깁니다. 그리고 이 영상의 시작 상태는 모두 “부품이 바닥에 놓인” 쪽이라서, 학습 때 캐시된 근접 상태로 연습한 정책이 처음부터 끝까지를 해낸다는 것을 보여 주는 영상입니다.
A7. Fig. 5: 공유 정책 vs 개별 정책, 이진 보상 vs dense 보상
📄 “With binary task rewards, one policy trained across all twenty tasks reaches higher training success than twenty separate specialists. Adding rewards for reaching and alignment reduces success in this experiment.”
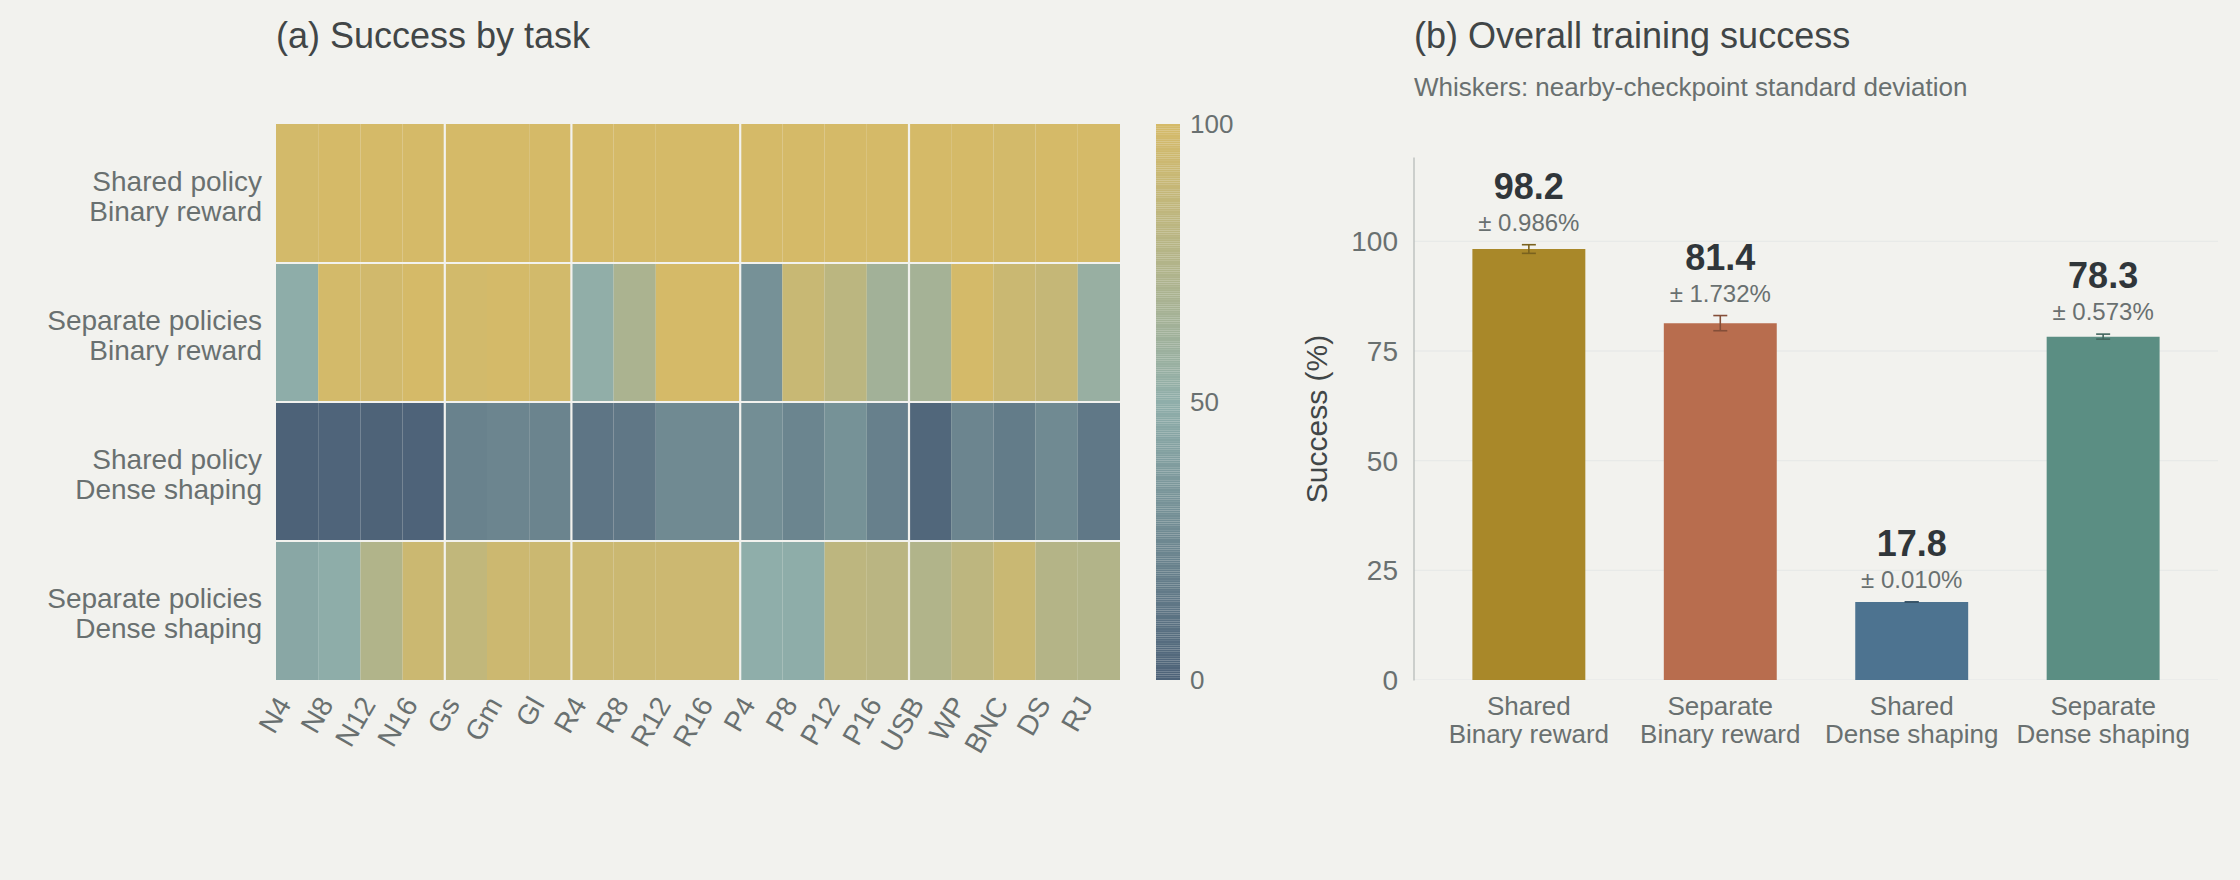
원문 Fig. 5 “Training success across varied starting states.”(SVG를 래스터화). (a) 과제별 성공률 히트맵, (b) 조건별 전체 학습 성공률 막대.
그림 읽기. (a)의 가로축은 20개 과제(N=너트, G=기어, R=로드, P=페그, 그 뒤 커넥터 5종), 세로축은 네 조건입니다. 색은 오른쪽 범례대로 0(남색)에서 100(황토색)입니다. 흰 세로선이 과제 계열을 나눕니다. (b)는 같은 네 조건의 전체 성공률이고, 수염(whisker)은 “인접 체크포인트 표준편차”입니다.
- 공유 정책 + 이진 보상: 98.2% (±0.99%p)
- 개별 정책 20개 + 이진 보상: 81.4% (±1.73%p)
- 공유 정책 + dense 보상: 17.8% (±0.01%p)
- 개별 정책 20개 + dense 보상: 78.3% (±0.57%p)
막대 위 라벨은 “± 0.986%”처럼 %로 적혀 있지만, 데이터 JSON의 units는 표준편차를 퍼센트포인트로 정의합니다.
히트맵 한 칸 한 칸의 값은 그림만 봐서는 색으로밖에 알 수 없는데, 📊 페이지가 같은 폴더에 둔 heterogeneous-training-data.json에 80개 값과 출처가 모두 들어 있습니다. 그대로 옮깁니다(단위 %).
| 과제 | 공유+이진 | 개별+이진 | 공유+dense | 개별+dense |
|---|---|---|---|---|
| N4 | 98.5 | 49.4 | 0.0* | 45.0 |
| N8 | 99.8 | 98.2 | 2.0 | 48.9 |
| N12 | 99.8 | 96.5 | 0.8 | 74.3 |
| N16 | 99.8 | 99.8 | 1.2 | 92.7 |
| Gs | 99.8 | 97.7 | 21.5 | 85.6 |
| Gm | 99.8 | 99.1 | 23.4 | 93.6 |
| Gl | 99.8 | 97.9 | 22.7 | 92.6 |
| R4 | 99.8 | 51.2 | 12.5 | 92.7 |
| R8 | 99.8 | 69.6 | 14.4 | 92.6 |
| R12 | 99.8 | 99.9 | 26.6 | 93.1 |
| R16 | 99.8 | 99.9 | 26.6 | 93.3 |
| P4 | 99.8 | 31.0 | 28.9 | 49.6 |
| P8 | 99.8 | 90.3 | 23.0 | 49.5 |
| P12 | 99.8 | 81.3 | 31.2 | 82.7 |
| P16 | 99.8 | 64.0 | 19.9 | 80.4 |
| USB | 99.8 | 65.6 | 3.5 | 73.9 |
| WP | 99.8 | 99.1 | 23.4 | 82.5 |
| BNC | 98.2 | 92.0 | 17.2 | 91.6 |
| DS | 99.8 | 88.3 | 26.6 | 76.4 |
| RJ | 99.8 | 56.2 | 14.8 | 74.6 |
| 행 평균(필자 계산) | 99.7 | 81.4 | 17.0 | 78.3 |
| 막대 값 | 98.2 | 81.4 | 17.8 | 78.3 |
* 공유+dense의 N4 0.0은 JSON이 “Paper plotting fallback: zero for a blank source CSV cell, not a measured zero” 라고 밝힌 값입니다. 측정된 0이 아니라 빈칸을 0으로 그린 것입니다.
표에서 읽히는 것:
- 개별 전문가 정책은 가장 작은 부품에서 무너집니다. 4 mm짜리 N4·R4·P4가 31~51%로 가장 낮습니다. JSON의
sparse_start_random_success_rate(부품이 흩어진 무작위 시작에서의 성공률)를 보면 이 셋은 0.000, 0.003, 0.000이고sparse_solved플래그도 0입니다. 즉 개별 정책은 4 mm 부품을 처음부터 조립하는 법을 끝내 배우지 못했고, 캐시된 근접 상태에서만 성공해서 50% 안팎의 학습 성공률이 나온 것으로 보입니다. 반면 공유 정책은 같은 과제에서 98~100%입니다. “다른 과제에서 배운 기술이 어려운 과제로 옮겨 간다”는 페이지의 주장(“Progress on one state can make another solvable”)이 과제 사이에서도 일어난다고 읽을 수 있는 대목입니다. - dense 보상은 공유 정책에서 특히 나쁩니다. 개별 정책에서는 dense가 이진보다 3%p 낮을 뿐인데(81.4 → 78.3), 공유 정책에서는 98.2 → 17.8로 무너집니다. 너트 계열은 0~2%입니다. 왜 그런지는 페이지가 설명하지 않습니다. JSON의 용어 설명에 따르면 dense 조건은 “retains the binary task reward and adds progress terms”, 즉 이진 보상에 진행 항(도달·정렬)을 더한 것입니다. 과제마다 크기가 다른 진행 항이 공유 정책 하나에 섞이면서, 쉽게 받을 수 있는 진행 보상 쪽으로 정책이 끌려갔을 가능성이 있습니다(✍️ 필자 추정, 원문 근거 없음).
- 개별+dense는 4 mm 계열 말고도 N8·P8이 50% 근처입니다. 층위별 값을 보면 이 두 과제는
grasp_asset_in_air(공중에서 쥔 상태)와start_grasped_then_assembled두 층위의 성공률이 0.0이고,start_fully_assembled·start_assembled두 층위는 97% 이상입니다(N4·P4도 같은 양상). 네 층위를 평균하니 50% 근처가 된 것이고, “쥔 상태에서 시작하면 전혀 못 하고, 거의 조립된 상태에서만 한다”는 뜻으로 읽힙니다.
이 그림을 읽을 때 반드시 알아야 할 단서. 📊 JSON의 interpretation 항목 8개가 그림이 보여 주지 않는 조건을 스스로 밝힙니다. 핵심만 옮깁니다.
- “These are training success metrics across mixed reset conditions, including partial assemblies, not a held-out start-random evaluation.” 모든 값은 부분 조립 상태가 섞인 학습 중 성공률입니다. 처음부터 조립하는 별도 평가가 아닙니다.
- “Shared binary heatmap: nineteen image-derived per-asset estimates from the reported run at iteration 120250 and 131072 environments; M4 is an author-local measurement with no recorded checkpoint or environment count.” 히트맵의 공유+이진 행만 iteration 120,250, 환경 131,072개 시점의 값이고, 그것도 원 로그가 아니라 이미지(색 구간)에서 읽어 낸 추정치입니다. 99.8이라는 값이 19칸에 반복되는 것은 색 구간 [0.996, 1.0]의 가운데값이기 때문입니다. N4만 체크포인트 기록이 없는 저자 로컬 측정입니다.
- “Shared binary aggregate bar: the reported run at iteration 25000, reported 64K environments. It is intentionally not the average of that heatmap row.” 반면 막대의 98.2%는 iteration 25,000, 환경 64K 시점입니다. 그래서 히트맵 행 평균(99.7)과 막대(98.2)가 다릅니다.
- 개별+이진은 iteration 25,000(기어는 14,999에서 끝난 값을 유지), 개별+dense는 과제마다 다른 최종 시점(9,588~14,999)의 층위 평균입니다.
- “They are not independent-training-seed uncertainty.” 수염은 −2,500·0·+2,500 iteration 체크포인트 사이의 표준편차이지, 독립 학습 시드 사이의 불확실성이 아닙니다.
- “Total compute is not matched.” 조건 사이 총 연산량이 맞춰져 있지 않습니다.
마지막 항목은 JSON의 다른 필드로 크기를 가늠할 수 있습니다. 각 행의 joint_gpu_hours는 410.3이고 sparse_gpu_hours는 과제별로 525.7~1,446.9, 20개를 합하면 16,115입니다. 두 값 모두 runtime_seconds × world_size(16) ÷ 3600과 정확히 일치합니다(예: 92,318 s × 16 ÷ 3600 = 410.3). 필드 이름대로라면 개별 정책 20개가 공유 정책보다 GPU 시간을 약 39배 더 썼는데도 성공률이 더 낮다는 뜻이 됩니다. 그러나 이 런타임이 어느 iteration까지의 시간인지 정의가 공개돼 있지 않고, 25,000 iteration까지의 시간으로 보면 개별 정책의 iteration당 시간이 공유 정책의 1.4~3.5배로 과제마다 크게 다르게 나오는 등 그대로 믿기 어려운 부분도 있어서 해석은 유보합니다. 확실한 것은 “공유 정책이 연산을 더 써서 이긴 것은 아니다” 정도입니다.
A8. emergent 행동 갤러리 8장
페이지 마지막 절 “Emergent assembly behavior”는 가로로 넘기는 이미지 8장입니다. 각 이미지는 한 에피소드에서 뽑은 5개 순간을 왼쪽에서 오른쪽 순서로 붙인 것입니다. 페이지의 버튼 라벨과 캡션, 접근성 설명(alt)을 함께 옮기고, 필자가 각 칸에서 본 것을 덧붙입니다.
① Peg regrasp (8 mm 페그)
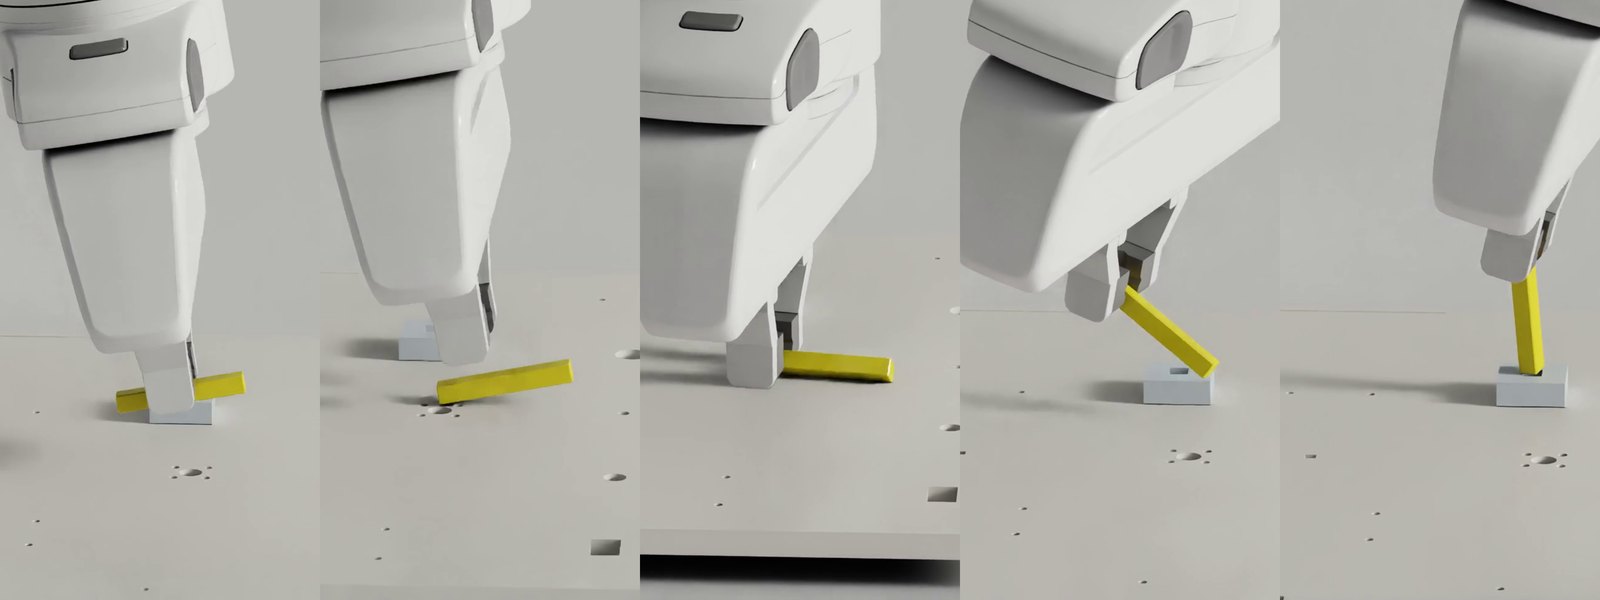
📄 “The gripper puts down the 8 mm peg and picks it up near one end, leaving more of the peg exposed for insertion.” 1칸: 페그 가운데를 쥐고 소켓 위에 있음. 2칸: 페그를 보드에 내려놓음. 3칸: 페그 끝 쪽으로 그리퍼를 옮김. 4칸: 끝을 쥐고 들어 올리며 페그가 비스듬히 섬. 5칸: 소켓에 수직으로 꽂힘.
가운데를 쥐면 그리퍼 몸체가 소켓에 닿아 페그를 끝까지 넣을 수 없습니다. 정책은 이 문제를 “내려놓고 다시 쥐기”로 풉니다. 평행 그리퍼에는 손 안에서 물체를 미끄러뜨릴 자유도가 없기 때문에 재파지가 유일한 방법입니다.
② Board reorientation (방수 커넥터)
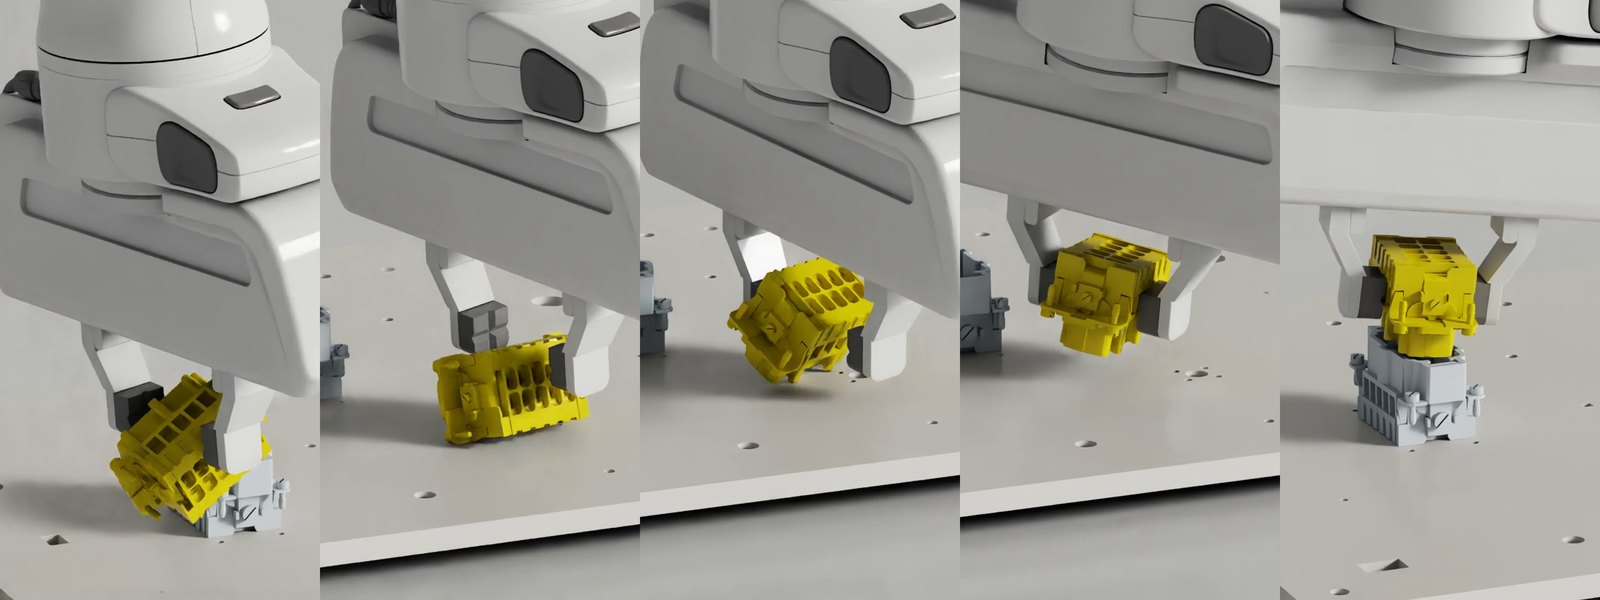
📄 “The gripper uses contact with the board to turn the waterproof connector before inserting it.” 1~3칸: 비스듬히 쥔 커넥터를 보드에 대고 누르면서 커넥터가 그리퍼 안에서 돌아감. 4칸: 커넥터가 바로 선 자세로 쥐어짐. 5칸: 소켓에 끼움.
외부 환경을 지렛목으로 써서 손 안 자세를 바꾸는 이른바 extrinsic dexterity입니다. 보드 표면이 “세 번째 손가락” 역할을 합니다.
③ Connector regrasp (D-sub)
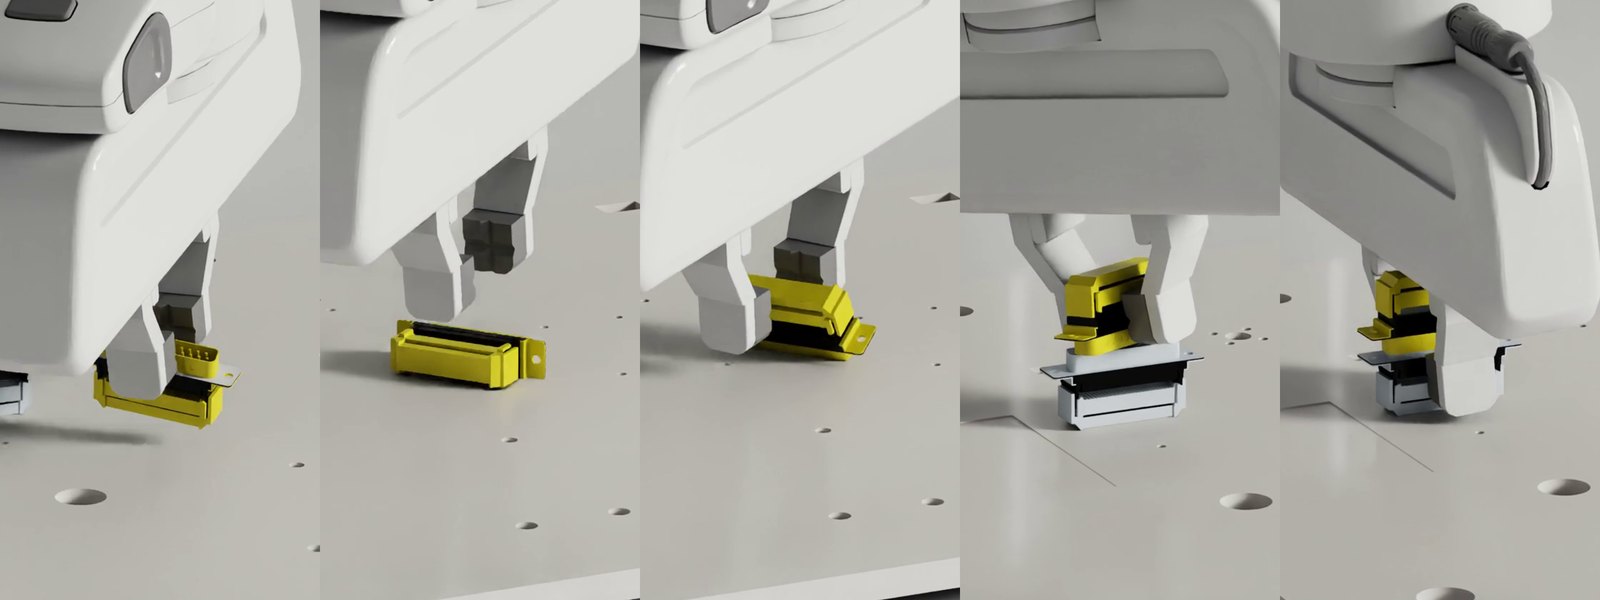
📄 “The D-sub connector is set down and regrasped to align it with its socket.” 1칸: D-sub를 옆으로 쥐고 있음. 2칸: 보드에 내려놓음(눕혀진 상태). 3칸: 다른 면을 다시 쥠. 4~5칸: 소켓 위로 정렬해 끼움.
④ Gear placement (중간 기어)
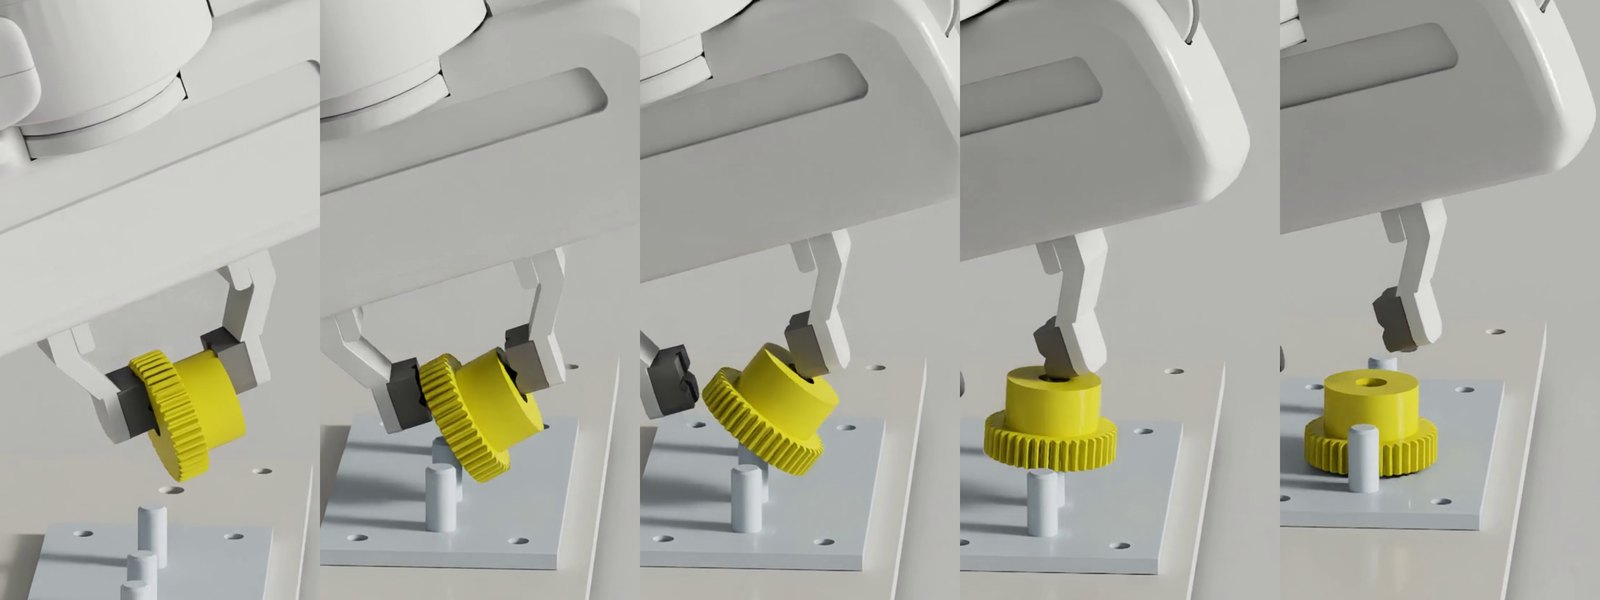
📄 “Held from the side, the medium gear pivots into a horizontal pose above its mounting post.” 1칸: 기어를 옆에서(회전축이 수평이 되게) 쥠. 2~3칸: 손가락 사이에서 기어가 축을 중심으로 기울며 돌아감. 4칸: 수평이 된 기어가 축 위에 놓임. 5칸: 그리퍼가 떨어지고 기어가 받침에 앉음.
그리퍼가 기어를 놓치지 않을 만큼만 쥐어서 중력과 접촉으로 기어가 피벗하게 하는 동작입니다. 손가락 끝을 회전축처럼 쓰는 셈입니다.
⑤ Nut reorientation (M12 너트)
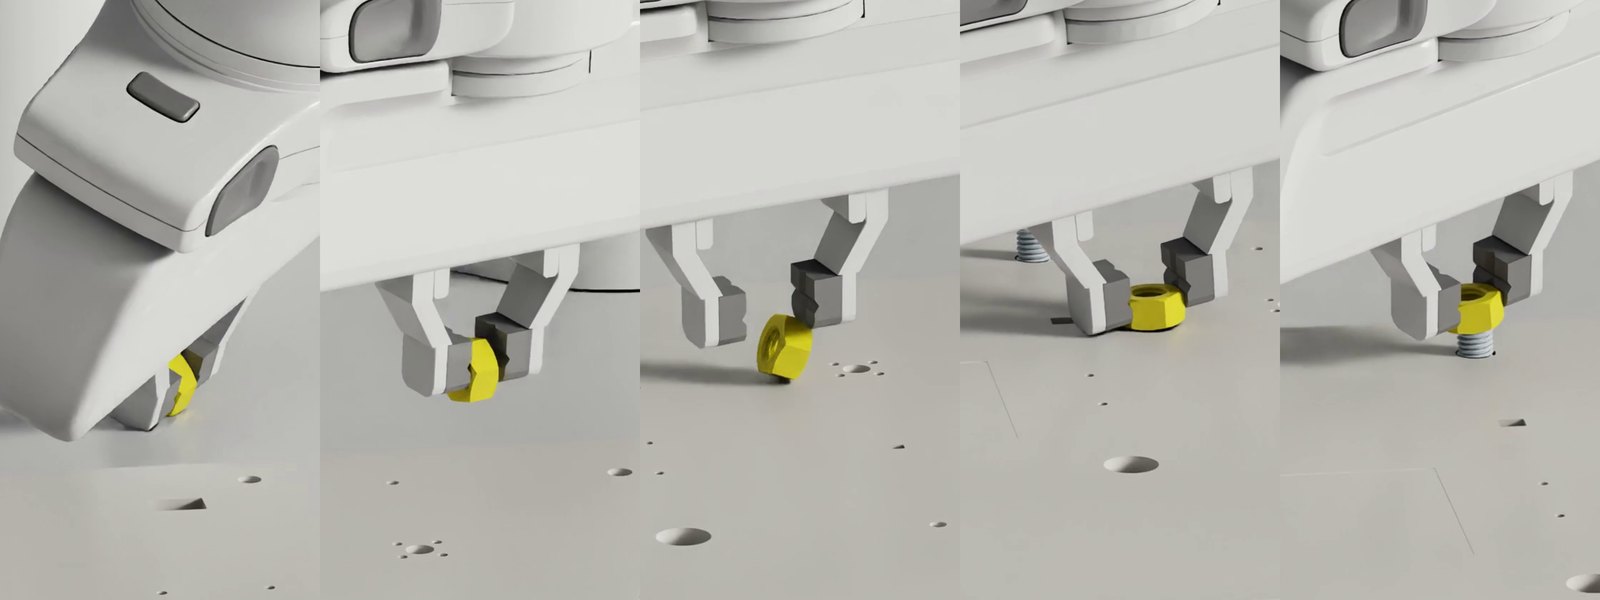
📄 “The gripper rolls the M12 nut from its edge onto a flat face before placing it on the bolt.” 1~2칸: 모서리로 선 너트를 손가락 끝으로 건드림. 3칸: 너트가 굴러 넘어감. 4칸: 면이 아래로 간 너트를 쥠. 5칸: 볼트 위에 올림.
⑥ Nut tapping (M4 너트)
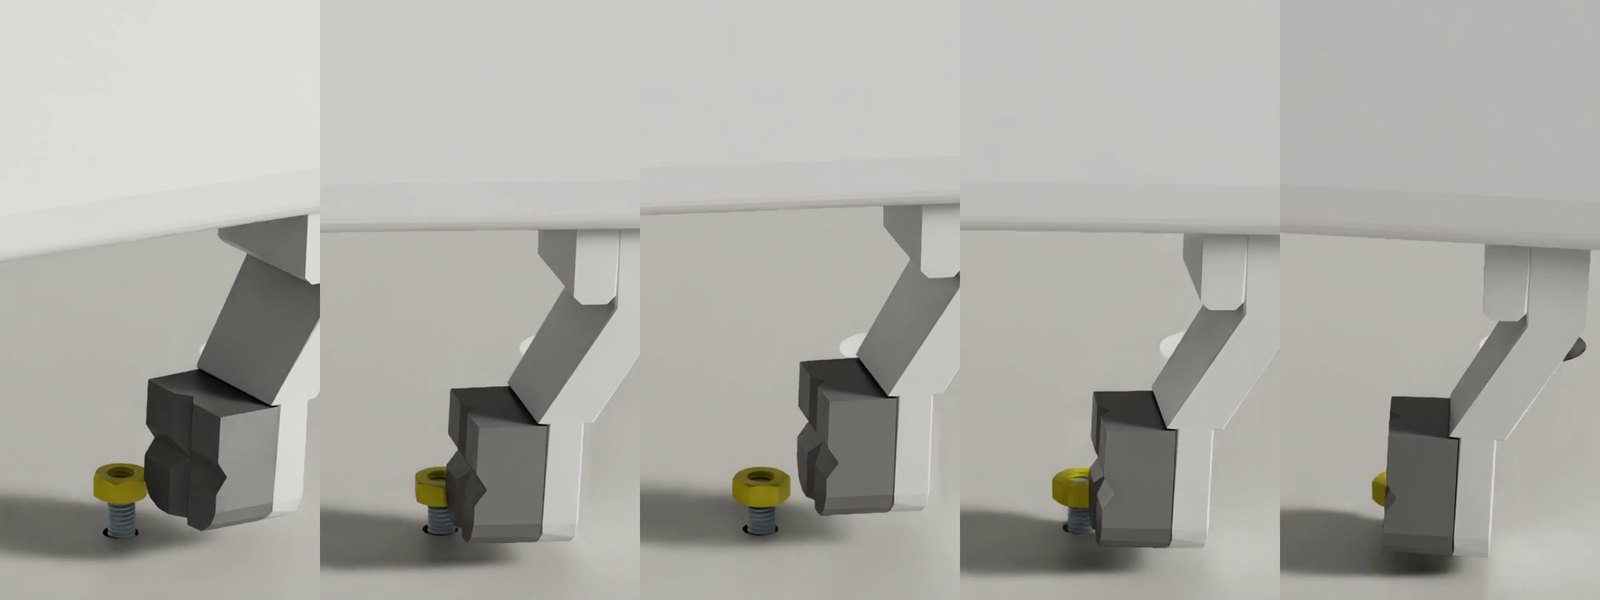
📄 “One-sided fingertip taps turn the M4 nut along the bolt.” 5칸 모두 같은 구도이고, 한쪽 손가락 끝이 너트 옆면에 닿았다 떨어지기를 반복하며 너트가 조금씩 볼트를 따라 내려갑니다.
이 이미지에서 손끝 패드가 M4 너트보다 눈에 띄게 큽니다. 4 mm 볼트용 너트는 너무 작아서 두 손가락으로 쥐고 돌리기가 어렵고, 정책은 한 손가락으로 “톡톡 쳐서” 돌리는 방법을 찾았습니다. Part B에서 손가락 크기 문제를 다룰 때 다시 씁니다.
⑦ Rod repositioning (8 mm 로드)
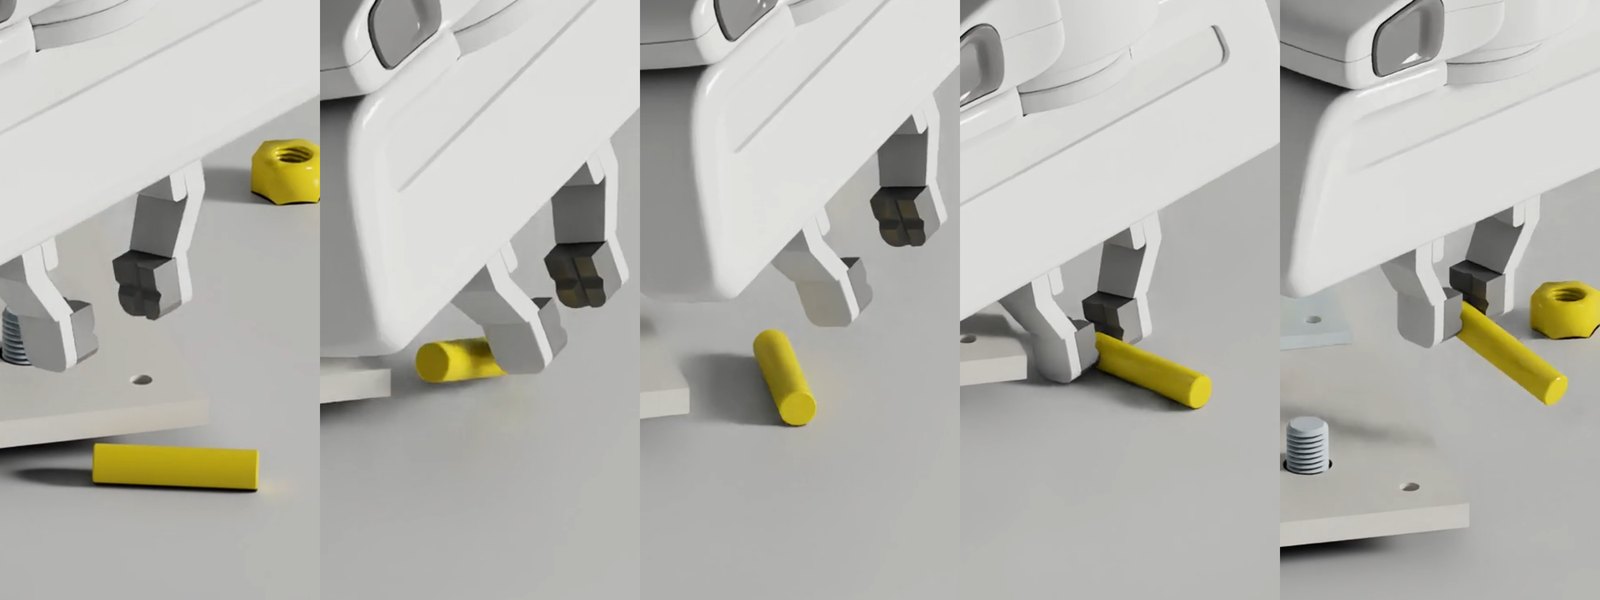
📄 “A fingertip pushes the 8 mm rod across the surface, before the gripper picks it up.” 1~3칸: 바닥의 로드를 손가락 끝으로 밀어 굴리며 위치를 바꿈. 4칸: 로드 끝 쪽을 쥠. 5칸: 들어 올림.
⑧ Circular threading (M16 너트)
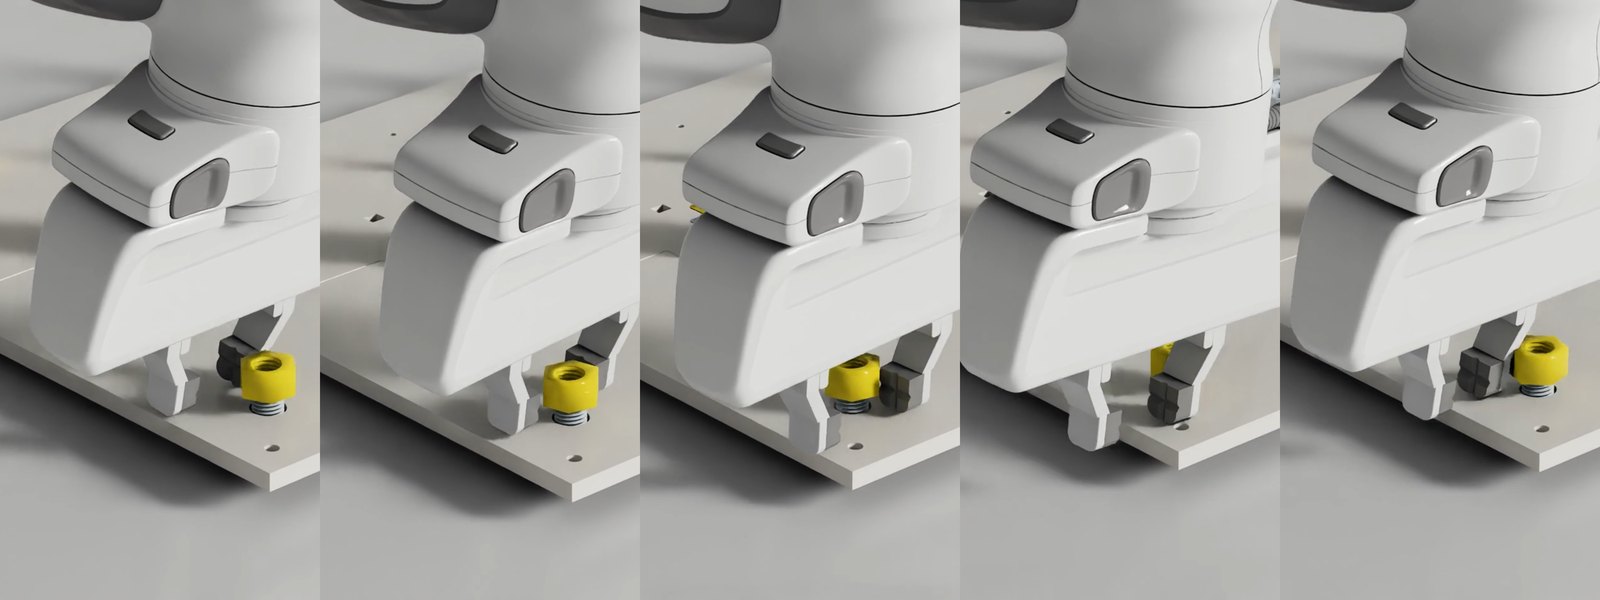
📄 “The gripper moves around the M16 nut, using fingertip contact to turn it along the bolt.” 5칸에서 그리퍼의 위치가 너트 둘레를 돌며 바뀝니다. 손가락 끝이 너트 옆면을 밀어 조금씩 돌립니다.
여덟 장을 모아 보면 공통점이 있습니다. 평행 그리퍼가 하지 못하는 손 안 조작을 재파지, 환경 접촉, 비파지(non-prehensile) 밀기로 대신하고 있다는 것입니다. 이 점이 Part B의 출발점입니다.
A9. 내레이션 overview 영상(4:36) 장면별 해설
히어로 영역에 링크로만 걸린 overview 영상(열기, 43 MB)은 페이지 본문보다 정보가 많습니다. 내레이션을 받아 적고 3초 간격 프레임과 대조해 장면 단위로 정리했습니다.
| 구간 | 화면 | 내레이션 요지 |
|---|---|---|
| 0:00~0:05 | 제목 “AlphaNIST: Emergent Assembly Skills from Binary Task Rewards” | 제목 |
| 0:05~0:15 | 완전 조립된 보드 클로즈업 | 기어 맞물림, 너트 체결부터 페그·커넥터 삽입까지 20개 과제 |
| 0:15~0:24 | “Four components” 4분할 슬라이드 | 이진 보상, 캐시된 시작 상태, Beta 샘플링, 대규모 병렬 경험 |
| 0:24~0:38 | “Complete the assembly.” 시작/완료 상태 쌍(방수 커넥터, 큰 기어, M12 너트, 16 mm 로드). 시작 칸 “Task reward: 0”, 완료 칸 “Task reward: 1 · episode ends” | 완료하면 1, 아니면 0. 도달·파지·부분 삽입 보상 없음 |
| 0:38~0:57 | “Cached resets” 시작 상태 장면들 | 느슨한 부품만으로는 삽입까지 가기 어려움. 쥔 상태·부분 조립 상태에서도 시작. 상태는 시뮬레이션에서 생성, “어디서 시작할지”만 정하지 행동을 정하지 않음 |
| 0:57~1:14 | “Beta sampling” 곡선, 식 w=\epsilon+\sqrt{p(1-p)} | 성공률 50% 근처 상태에 가장 큰 가중치, 모든 상태는 계속 후보로 유지 |
| 1:14~1:25 | “Up to 256K parallel environments · 4K per GPU”, 격자 “64 GPUs × 4K environments” | 최대 256,000 병렬 환경, GPU당 4,000 |
| 1:25~1:39 | “One shared policy across assemblies”: 입력 Surface point clouds + Robot state → Shared policy → 20 single-component tasks | 입력은 point cloud와 로봇 상태, 시연도 부품별 컨트롤러도 없음 |
| 1:39~1:54 | 막대 “One shared policy 98.2%” vs “Twenty specialists 81.4%” | 공유 정책 98%, 개별 정책 81% |
| 1:54~2:35 | “Scaling and ablations” 선 그래프(아래 별도 해설) | 전체 방법 97.4%, dense 추가 시 약 20%p 하락, 균등 샘플링 시 약 13%p 하락 |
| 2:36~2:43 | “Short-horizon dexterity”: 기어를 비스듬히 쥐고 돌려 맞춤 | 정해 준 파지 없이 기어를 기울여 쥐고 정렬 |
| 2:46~2:56 | “Release → end regrasp → insertion”, “Repositioning before pickup” | 페그 재파지, 보드 가장자리에서 페그를 떼어낸 뒤 집기 |
| 2:57~3:02 | “Surface contact changes the part’s pose” | 커넥터를 보드에 눌러 돌리기 |
| 3:03~3:18 | “Different nuts, different turning motions”: M4 Fingertip tapping / M12 Outside-finger turns / M8 Circular motion | 너트 크기와 거리에 따라 돌리는 방식이 다름 |
| 3:18~3:40 | “Changing the workspace”: 10부품 장면 | 보상은 모든 부품이 조립됐을 때만, 순서는 정책이 고름. 부품 치우기, 겹친 기어 떼어내기 |
| 3:40~3:56 | “Gear-tooth alignment”: 작은 기어 / 중간 기어 | 이웃 기어가 있으면 그냥 내리면 안 되고, 돌려서 이빨을 맞춘 뒤 안착 |
| 3:56~4:18 | “Neighbor-aware turning”: M12, 이더넷 커넥터 옆 | 짧게 돌리고 손가락 위치를 바꾸며 커넥터를 피함 |
| 4:18~4:36 | “Conclusion: Learning dexterity and coordination” + QR 코드 | 공유 학습이 개별보다 낫고, 이진 보상이 시험한 dense 보상보다 나으며, 여러 부품에서는 순서도 배움 |
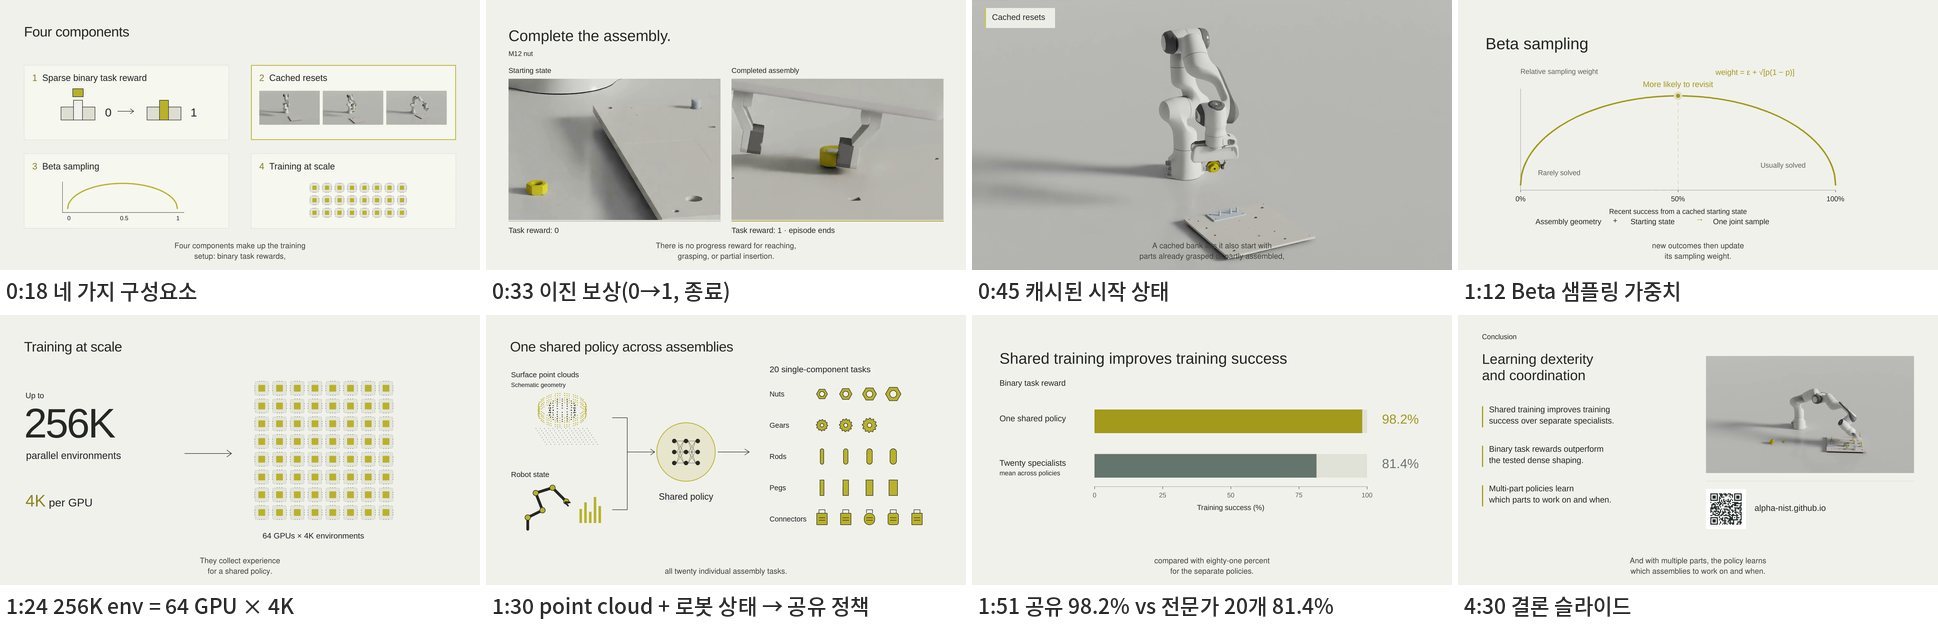
overview 영상의 방법·결과 슬라이드(필자 추출). 1:12의 Beta 샘플링 슬라이드 아래에 “Assembly geometry + Starting state → One joint sample”이라는 문구가 있습니다. 샘플링 단위가 “과제와 시작 상태의 쌍”이라는 뜻으로 읽힙니다. 1:30 슬라이드는 정책 입력을 “Surface point clouds (schematic geometry)”와 “Robot state”로 그립니다.
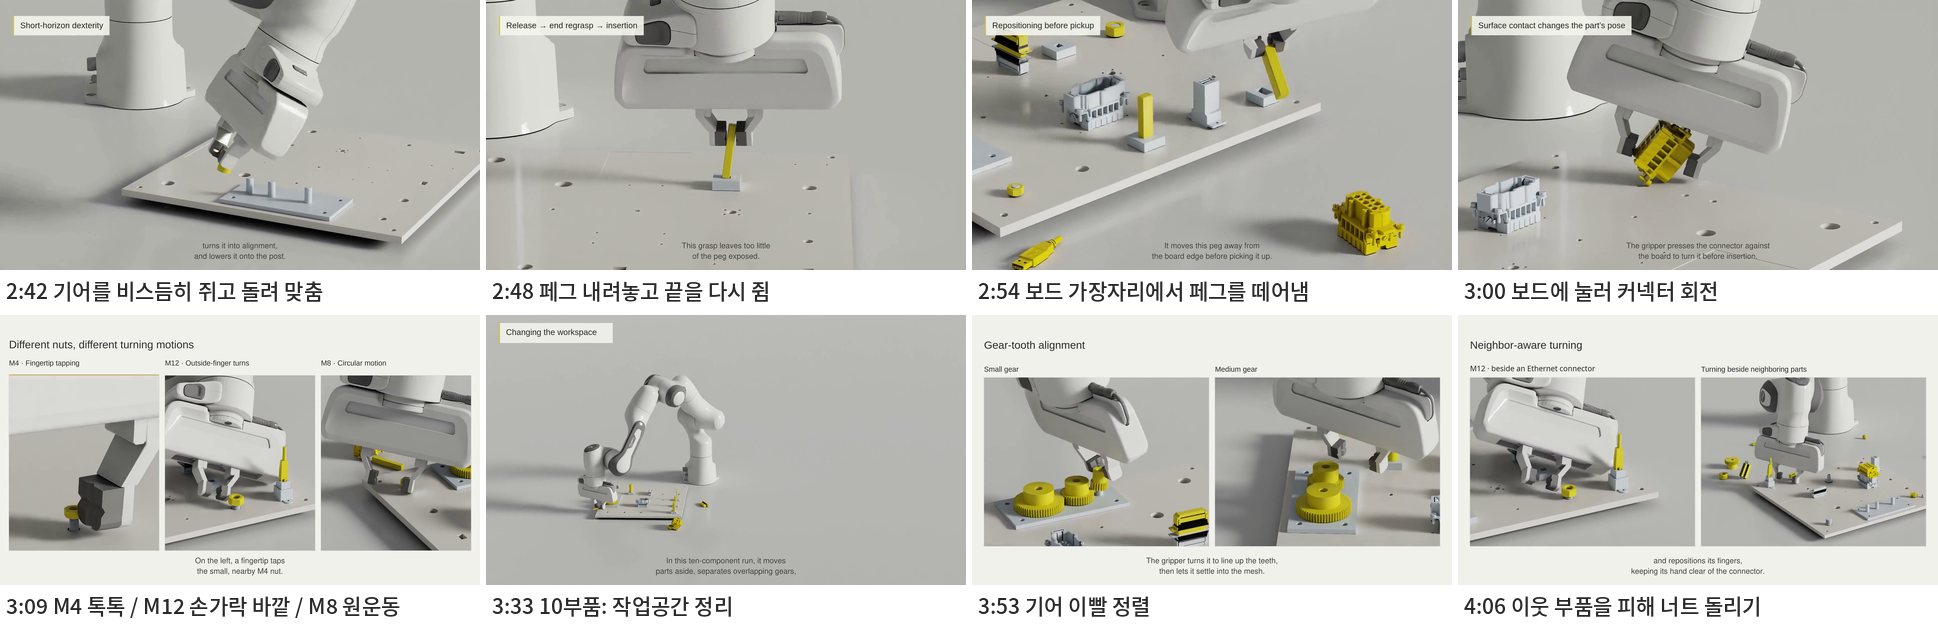
overview 영상의 행동 장면(필자 추출). 3:09의 3분할은 같은 “너트 돌리기”라도 M4는 손끝 톡톡, M12는 손가락 바깥면으로 돌리기, M8은 원운동이라는 서로 다른 전략을 씀을 보여 줍니다. 4:06은 이미 꽂힌 이더넷 커넥터 옆에서 손을 부딪치지 않게 짧게 돌리는 장면입니다.
페이지 갤러리와 내레이션을 맞대 보면 같은 너트에 다른 전략이 붙어 있습니다. 갤러리의 M12는 “모서리에서 면으로 굴리기”이고 내레이션의 M12는 “손가락 바깥면 돌리기”입니다. 갤러리의 원운동은 M16이고 내레이션의 원운동은 M8입니다. 서로 다른 클립이므로 모순은 아니고, 오히려 같은 정책이 상황(거리, 이웃 부품)에 따라 다른 전략을 쓴다는 증거입니다.
Scaling and ablations 그래프. 페이지 본문에는 없고 영상에만 있는 그래프라서 따로 해설합니다.
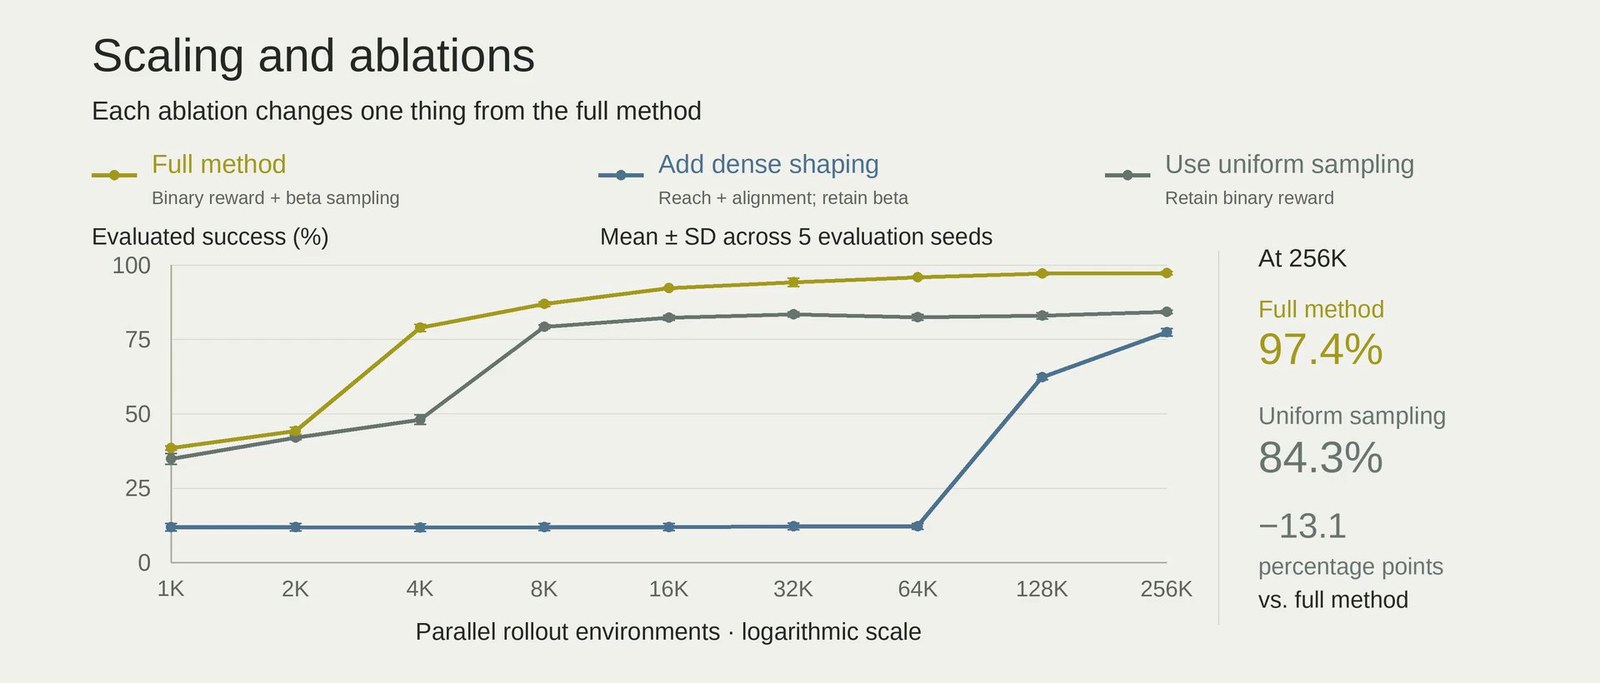
overview 영상 2:35의 “Scaling and ablations”(필자 캡처). 가로축은 병렬 롤아웃 환경 수(1K~256K, 로그 축), 세로축은 “Evaluated success (%)”, 오차 막대는 “Mean ± SD across 5 evaluation seeds”입니다. 노란 선이 전체 방법(이진 보상 + Beta 샘플링), 파란 선이 dense 보상 추가(도달 + 정렬, Beta 유지), 회색 선이 균등 샘플링(이진 보상 유지)입니다.
슬라이드에 숫자로 적힌 것은 256K에서의 값 세 개입니다. 전체 방법 97.4%, dense 77.4%(−19.9%p), 균등 84.3%(−13.1%p). 나머지 점은 숫자가 없어서 축 눈금을 기준으로 픽셀 위치에서 읽었습니다(±1%p 정도의 오차가 있는 필자 판독값).
| 병렬 환경 | 1K | 2K | 4K | 8K | 16K | 32K | 64K | 128K | 256K |
|---|---|---|---|---|---|---|---|---|---|
| 전체 방법 | ≈38 | ≈44 | ≈79 | ≈87 | ≈92 | ≈94 | ≈96 | ≈97 | 97.4 |
| 균등 샘플링 | ≈35 | ≈42 | ≈48 | ≈79 | ≈82 | ≈83 | ≈82 | ≈83 | 84.3 |
| dense 보상 | ≈12 | ≈12 | ≈12 | ≈12 | ≈12 | ≈12 | ≈12 | ≈62 | 77.4 |
읽을 거리가 셋입니다.
- Beta 샘플링의 이득은 규모마다 다릅니다. 4K에서 전체 방법이 79%로 뛰어오를 때 균등 샘플링은 48%에 머물고(약 31%p 차이), 균등 샘플링은 8K에서야 따라옵니다. 그 뒤로는 13%p 안팎의 차이가 256K까지 좁혀지지 않습니다. 같은 환경 수라면 “어떤 상태를 연습시키느냐”가 성능 천장을 정한다는 뜻입니다.
- dense 보상은 64K까지 약 12%에 멈춰 있다가 128K에서야 올라갑니다. 환경을 충분히 늘리면 dense 조건도 어느 정도 회복하지만(77.4%), 그래도 전체 방법보다 20%p 낮습니다. 슬라이드 문구는 “more detailed rewards do not necessarily make this task easier to learn” 입니다.
- 이 그래프의 성공률은 Fig. 5와 다른 지표입니다. Fig. 5는 “학습 중 성공률”, 이 그래프는 “평가 성공률(평가 시드 5개)”입니다. 64K에서 전체 방법이 약 96%라는 이 그래프의 값과, 같은 64K에서 98.2%라는 Fig. 5의 값이 다른 것은 그 때문입니다. 평가가 어떤 시작 상태 분포에서 이루어졌는지는 밝혀져 있지 않습니다. 오차 막대도 “평가 시드”이지 학습 시드가 아닙니다.
덧붙이면 dense의 “−19.9%p”는 화면에 표시된 반올림 값끼리 빼면(97.4 − 77.4) 20.0이 됩니다. 반올림 전 값으로 계산했기 때문으로 보입니다.
A10. 비판적으로 보면
강점
- 시연도 단계 설계도 없이 정밀 조립 20종을 한 정책으로. 4 mm 부품까지 포함한 NIST 보드 전체를 공유 정책 하나로 98%(학습 성공률) 풀었고, 개별 전문가 정책이 끝내 못 푼 4 mm 계열까지 풀었습니다. “과제 사이 전이”가 실제로 있다는 근거입니다.
- dense 보상의 함정을 정량으로 보여 줍니다. 공유 정책에서 98.2 → 17.8, 스케일링 그래프에서 64K까지 12% 정체라는 숫자는 “보상을 친절하게 만들수록 좋다”는 통념에 대한 구체적인 반례입니다.
- emergent 행동의 다양성. 재파지, 환경 이용 회전, 손끝 톡톡, 원운동, 이웃 부품 회피, 작업공간 정리 같은 행동이 영상과 이미지로 잘 정리돼 있고, 같은 너트라도 상황에 따라 전략이 달라집니다.
- 스스로 한계를 밝힌 데이터 파일. Fig. 5의 JSON이 체크포인트 불일치, 이미지에서 읽은 값, 빈칸을 0으로 그린 값, 연산량 불일치를 숨기지 않고 적어 둡니다. 프로젝트 페이지로서는 드문 투명성입니다.
약점·한계
- 논문도 코드도 없습니다. 학습 알고리즘, 시뮬레이터, 행동 공간, 보상 계수, 은행 크기, 은행 생성 방법이 전부 비어 있습니다. 재현은 물론이고 결과의 의미를 검증할 수단도 없습니다.
- Fig. 5는 같은 조건끼리의 비교가 아닙니다. 공유+이진 히트맵은 iteration 120,250·환경 131,072개 시점의 이미지 판독값이고, 막대는 iteration 25,000·64K 시점이며, 다른 조건은 또 다른 시점입니다. 오차 막대는 학습 시드가 아니고, 총 연산량도 맞추지 않았습니다. 그림을 처음 보는 독자는 이것을 알 수 없고, JSON을 열어 봐야 알 수 있습니다.
- “학습 중 성공률”이 주 지표입니다. 근접 시작 상태가 섞인 성공률이라, 처음부터 조립하는 능력은 과대평가될 수 있습니다. 스케일링 그래프가 “평가 성공률”을 보여 주지만 평가 분포가 밝혀져 있지 않습니다.
- 시뮬레이션에만 머뭅니다. 관련 SGS 논문은 UR5e로 실물 zero-shot 전이를 보였지만 AlphaNIST 페이지에는 실물 결과가 없습니다. “부품을 던져 치우기” 같은 행동이 실물에서 허용될지도 미지수입니다.
- 10부품 정책은 별도 정책입니다. 단일 부품 공유 정책이 그대로 10부품을 하는 것이 아니고, 10부품 영상은 성공한 에피소드 4개를 고른 것입니다(“Four successful ten-part runs”). 성공률은 공개돼 있지 않습니다.
- dense 보상 비교의 범위. 시험한 dense 보상은 “도달 + 정렬” 한 가지입니다. 페이지도 “the dense shaping we tested” 라고 범위를 한정합니다. “dense 보상 일반이 나쁘다”로 읽으면 과대 해석입니다.
Part B. 고자유도 다지 손으로 바꾸면? (필자 분석)
⚠️ 이 Part 전체는 원문에 없는 필자의 분석과 가설입니다. AlphaNIST 페이지는 다지 손을 한 번도 다루지 않습니다. 아래 그림은 모두 필자 제작 개념도이며, 숫자는 ① 원문 값, ② 다른 논문이나 공개 사양의 값, ③ 필자의 가정과 계산을 구분해 표기했습니다. 실험으로 확인한 수치는 하나도 없습니다.
B1. 행동 공간: 7~8차원에서 23~29차원으로
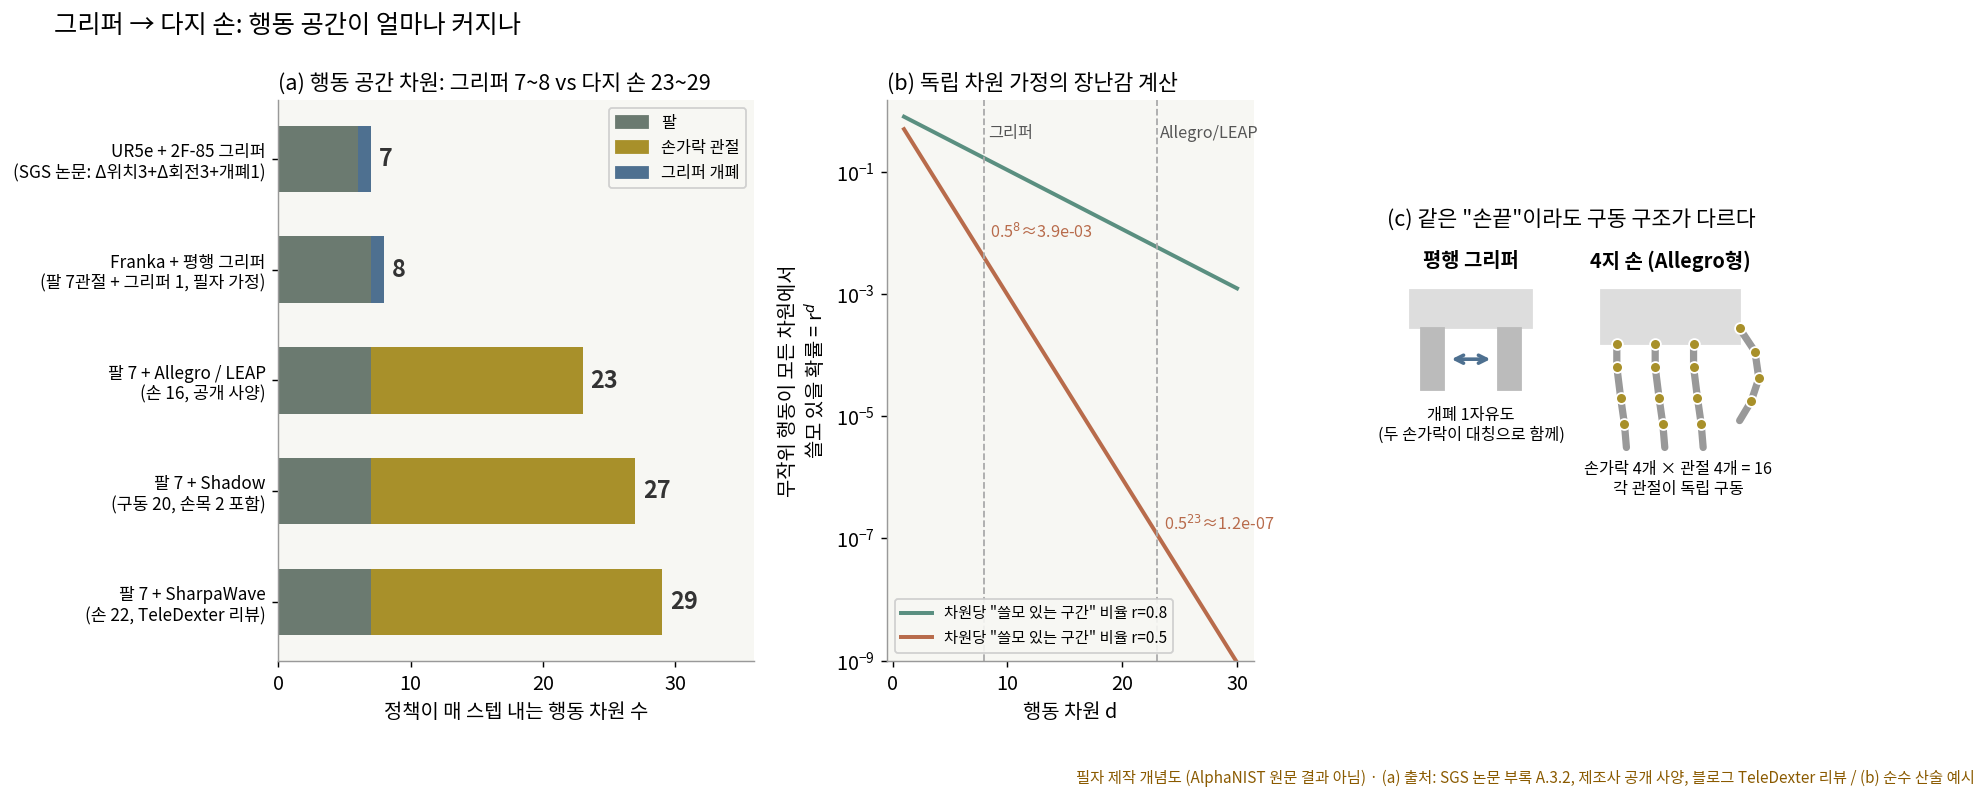
필자 제작 개념도. (a) 정책이 매 스텝 내는 행동 차원 수. UR5e 값은 SGS 논문 부록 A.3.2(Cartesian 증분 6 + 그리퍼 개폐 1), Franka 값은 팔 7관절 + 그리퍼 1을 필자가 가정한 것입니다(SGS의 Franka는 관절 위치 제어). 손 관절 수는 공개 사양(Allegro·LEAP 16, Shadow 구동 20)과 블로그의 TeleDexter 리뷰(SharpaWave 22)에서 가져왔습니다. AlphaNIST 자체의 행동 공간은 페이지에 없습니다. (b) 각 차원에서 “쓸모 있는 값”이 나올 비율이 r이고 차원이 서로 독립이라는 장난감 가정에서, 무작위 행동이 모든 차원에서 쓸모 있을 확률 r^d. (c) 평행 그리퍼와 4지 손의 구동 구조 비교.
평행 그리퍼는 두 손가락이 대칭으로 함께 움직이므로 손의 자유도가 1입니다. 팔까지 합쳐도 7~8차원입니다. Allegro·LEAP 같은 4지 손을 달면 손에서만 16차원이 늘어 23차원이 되고, Shadow는 구동 20(손목 2 포함, 제조사 사양)이라 팔과 합쳐 27차원 안팎, 블로그의 TeleDexter 리뷰가 다룬 SharpaWave는 손 22차원이라 29차원이 됩니다.
차원이 3배가 되면 탐색은 3배가 아니라 지수적으로 어려워질 수 있습니다. (b)는 이것을 가장 단순하게 계산한 것입니다. 차원마다 절반(r = 0.5)만 쓸모 있다고 하면, 8차원에서 무작위 행동이 전부 쓸모 있을 확률은 0.5^8 \approx 3.9\times10^{-3}, 23차원에서는 0.5^{23}\approx1.2\times10^{-7}입니다. 3만 배 차이입니다. 물론 실제 손가락 관절은 독립이 아니고(쥐는 동작은 여러 관절이 함께 움직임), 정책은 무작위가 아니므로 이 숫자 자체에 의미를 두면 안 됩니다. 말하려는 것은 방향입니다. 이진 보상만으로 학습하는 방식은 “우연히 한 번 성공하는 것”에 기대는데, 그 우연의 확률이 차원에 대해 곱셈으로 줄어든다는 것입니다.
B2. 이진 보상만으로 학습이 될까
AlphaNIST는 이미 그리퍼에서도 이 문제를 겪었습니다. 🎙️ “From loose parts alone, an untrained policy may rarely reach insertion.” 그래서 근접 시작 상태를 은행에 넣었습니다. 손으로 바꾸면 이 대책의 전제가 흔들립니다.
- “거의 다 된 상태”가 더 이상 쉽지 않습니다. 그리퍼에서는 부품이 소켓 바로 위에 있고 그리퍼가 쥐고 있으면, “내리기”만 하면 성공입니다. 손에서는 같은 상태라도 손가락 16개 관절이 파지를 유지하면서 내려야 합니다. 무작위에 가까운 초기 정책이면 손가락이 풀리며 부품을 떨어뜨릴 수 있습니다. 즉 역방향 커리큘럼의 “쉬운 끝”이 그리퍼만큼 쉽지 않습니다.
- 그래서 필자의 예측은 다음과 같습니다. 이진 보상만으로도 학습은 가능할 수 있지만, 그 조건은 ① 은행이 손 전용 근접 상태(안정된 파지, 손 안 재배향 중간 상태)를 훨씬 촘촘하게 가져야 하고, ② 환경 수가 더 커야 하며, ③ 행동 공간에 어떤 구조를 넣는 것이 거의 필수일 것이라는 점입니다.
③이 AlphaNIST의 철학과 충돌하는 지점입니다. 다지 손 연구들은 높은 차원을 다루려고 행동 공간을 줄이거나 다듬습니다. NestDex 리뷰는 20차원 손 행동을 H-VAE로 10차원 잠재 공간에 압축했고, DextrAH-G 리뷰는 23자유도 팔-손에 geometric fabric을 깔아 행동을 유도하고 충돌을 피합니다. TeleDexter 리뷰도 22-DoF 손에서 희소 subgoal 보상에 작은 dense 추적 보상을 더한 형태로 RL을 돌렸습니다. “보상은 결과만, 나머지는 로봇이”라는 AlphaNIST의 원칙을 다지 손에서도 지키려면, 보상 대신 행동 공간이나 시작 상태 쪽에 사전 지식을 넣는 것이 현실적인 타협이 될 것입니다(✍️ 필자 가설).
원문 A3의 문장도 다시 볼 만합니다. 📄 “A two-finger gripper may also need solutions quite different from those that come naturally to a human hand.” 시연을 쓰지 않는 근거 중 하나가 “그리퍼는 사람 손과 다르다”였습니다. 사람 손과 닮은 다지 손이라면 이 근거가 약해집니다. 사람 손-물체 궤적을 추적하는 DexTrack 리뷰, ManipTrans 리뷰나 원격조작 데이터를 쓰는 DexPilot 리뷰 같은 사람 기반 사전 지식이 그리퍼보다 손에서 훨씬 잘 옮겨 가기 때문입니다. 다지 손에서는 “시연 없이”가 원칙이라기보다 선택이 됩니다. 그 선택의 대가는 탐색 비용이고, 이득은 사람이 생각하지 못한 전략입니다.
B3. Beta 샘플링은 왜 고차원에서 더 중요해지나
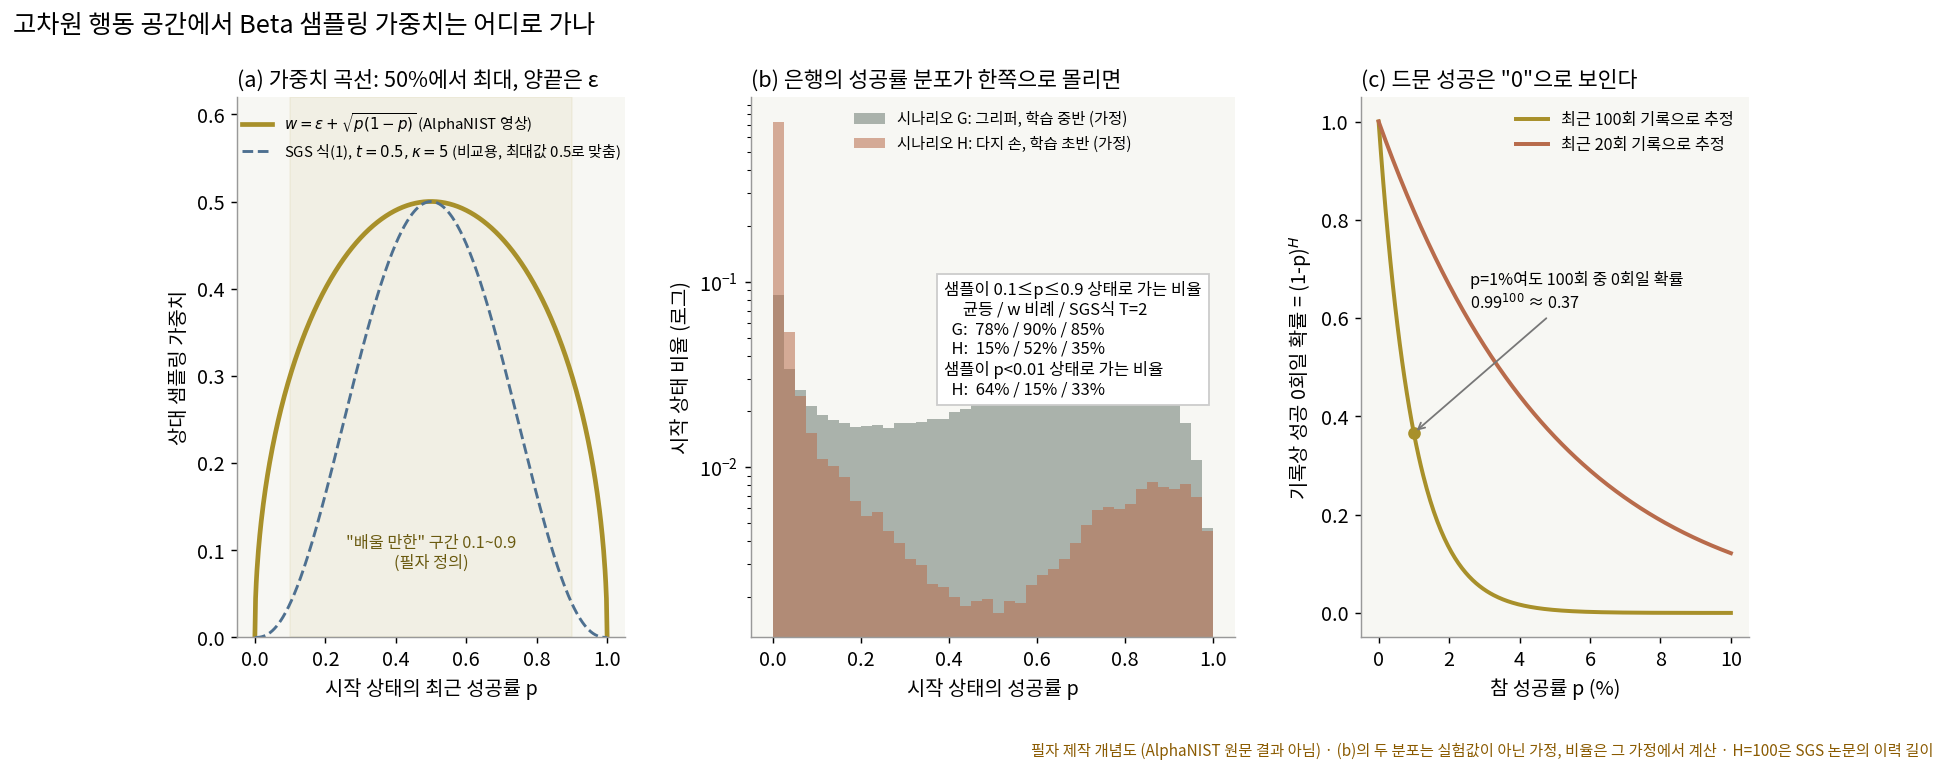
필자 제작 개념도. (a) AlphaNIST 영상의 가중치 곡선과, 비교용 SGS 식(1)의 κ=5 곡선. 회색 띠 0.1~0.9는 필자가 정한 “배울 만한 구간”. (b) 시작 상태 은행의 성공률 분포를 두 가지로 가정했을 때(G: 그리퍼 학습 중반, H: 다지 손 학습 초반) 샘플이 어디로 가는지 계산한 결과. 두 분포는 실험값이 아니라 필자가 Beta 혼합분포로 만든 가정입니다. (c) 참 성공률이 p인 상태에서 최근 H번 기록이 모두 실패일 확률 (1−p)^H. H=100은 SGS 논문의 이력 길이입니다.
(b)의 가정은 이렇습니다. 그리퍼 학습 중반(G)에는 시작 상태의 성공률이 0~1에 고루 퍼져 있습니다. 다지 손 학습 초반(H)에는 대부분의 상태가 성공률 거의 0이고, 소수의 근접 상태만 높으며, 가운데 “배울 만한 구간”이 얇습니다. 이 가정에서 샘플이 0.1 ≤ p ≤ 0.9 상태로 가는 비율을 계산하면(필자 계산, 상태 64,000개 표본):
| 시나리오(가정) | 균등 샘플링 | w에 비례 | SGS식 온도 T=2 |
|---|---|---|---|
| G: 그리퍼, 학습 중반 | 78% | 90% | 85% |
| H: 다지 손, 학습 초반 | 15% | 52% | 35% |
| H에서 p < 0.01 상태로 가는 샘플 | 64% | 15% | 33% |
이 표가 말하는 것은 두 가지입니다.
- Beta 샘플링의 이득은 분포가 치우칠수록 커집니다. G에서는 균등 샘플링도 이미 78%를 배울 만한 상태에 쓰니 Beta의 이득이 12%p입니다. H에서는 균등 샘플링이 15%만 쓰고 64%를 가망 없는 상태에 버리는데, Beta 가중치가 이것을 52%로 끌어올립니다. 원문 스케일링 그래프에서 Beta와 균등의 차이가 4K 같은 작은 규모에서 가장 컸던 것(약 31%p)과 같은 방향입니다.
- 그래도 치우침을 다 이기지는 못합니다. 가중치는 상대적이라서, 가망 없는 상태가 은행의 70%를 차지하면 각 상태의 가중치가 작아도 합이 커집니다. 온도를 쓰면(SGS 방식) 그 몫이 33%까지 올라갑니다. 다지 손에서는 샘플링 규칙보다 은행의 구성이 더 중요해진다는 뜻입니다.
(c)는 더 근본적인 문제입니다. 성공률을 최근 100번의 평균으로 추정하면, 참 성공률이 1%인 상태도 100번 중 한 번도 성공하지 않을 확률이 0.99^{100}\approx0.37입니다(필자 계산). 즉 이제 막 풀리기 시작한 상태의 3분의 1 이상이 “성공률 0”으로 기록돼 바닥 가중치 \epsilon만 받습니다. 다지 손 학습 초반처럼 드문 성공이 대부분인 시기에는 Beta 가중치가 학습 경계(frontier)를 제대로 보지 못합니다. 보완 방향으로는 ① 상태 하나가 아니라 비슷한 상태 묶음(층위)의 성공률을 함께 쓰는 것, ② 성공률이 낮은 상태는 이력을 더 길게 보는 것, ③ “부분 진척”을 보상이 아니라 샘플링 신호로만 쓰는 것(정책은 이진 보상으로 학습하되, 어디를 연습시킬지는 접촉 유지 시간 같은 진척도로 고르기)이 떠오릅니다. 셋 다 필자의 제안이고 검증된 것이 아닙니다.
시작 상태 설계도 달라집니다. 그리퍼의 “손 안 파지 상태”는 사실상 한 종류입니다(두 손가락이 부품을 집음). 손에서는 파지 유형(감싸 쥐기, 정밀 핀치, 세 손가락 쥐기), 어느 손가락이 닿는지, 손 안에서의 부품 자세가 모두 달라서 은행의 축이 훨씬 많아집니다. 또 시뮬레이션에서 그 상태가 실제로 안정적인 파지인지 확인하는 단계가 필요합니다. 원문 시작 상태 영상이 정책 행동 없이 상태를 잠깐 유지하는 것(“held briefly without policy actions”)도 그런 확인 장면으로 읽힙니다(✍️ 필자 해석). 대규모 파지 데이터셋을 사전학습 코퍼스로 쓴 From Grasps to Dexterity 리뷰처럼, 파지 데이터셋을 은행의 시작 상태 생성기로 쓰는 것이 자연스러운 확장입니다.
B4. emergent 전략은 손에서 어떻게 바뀌나
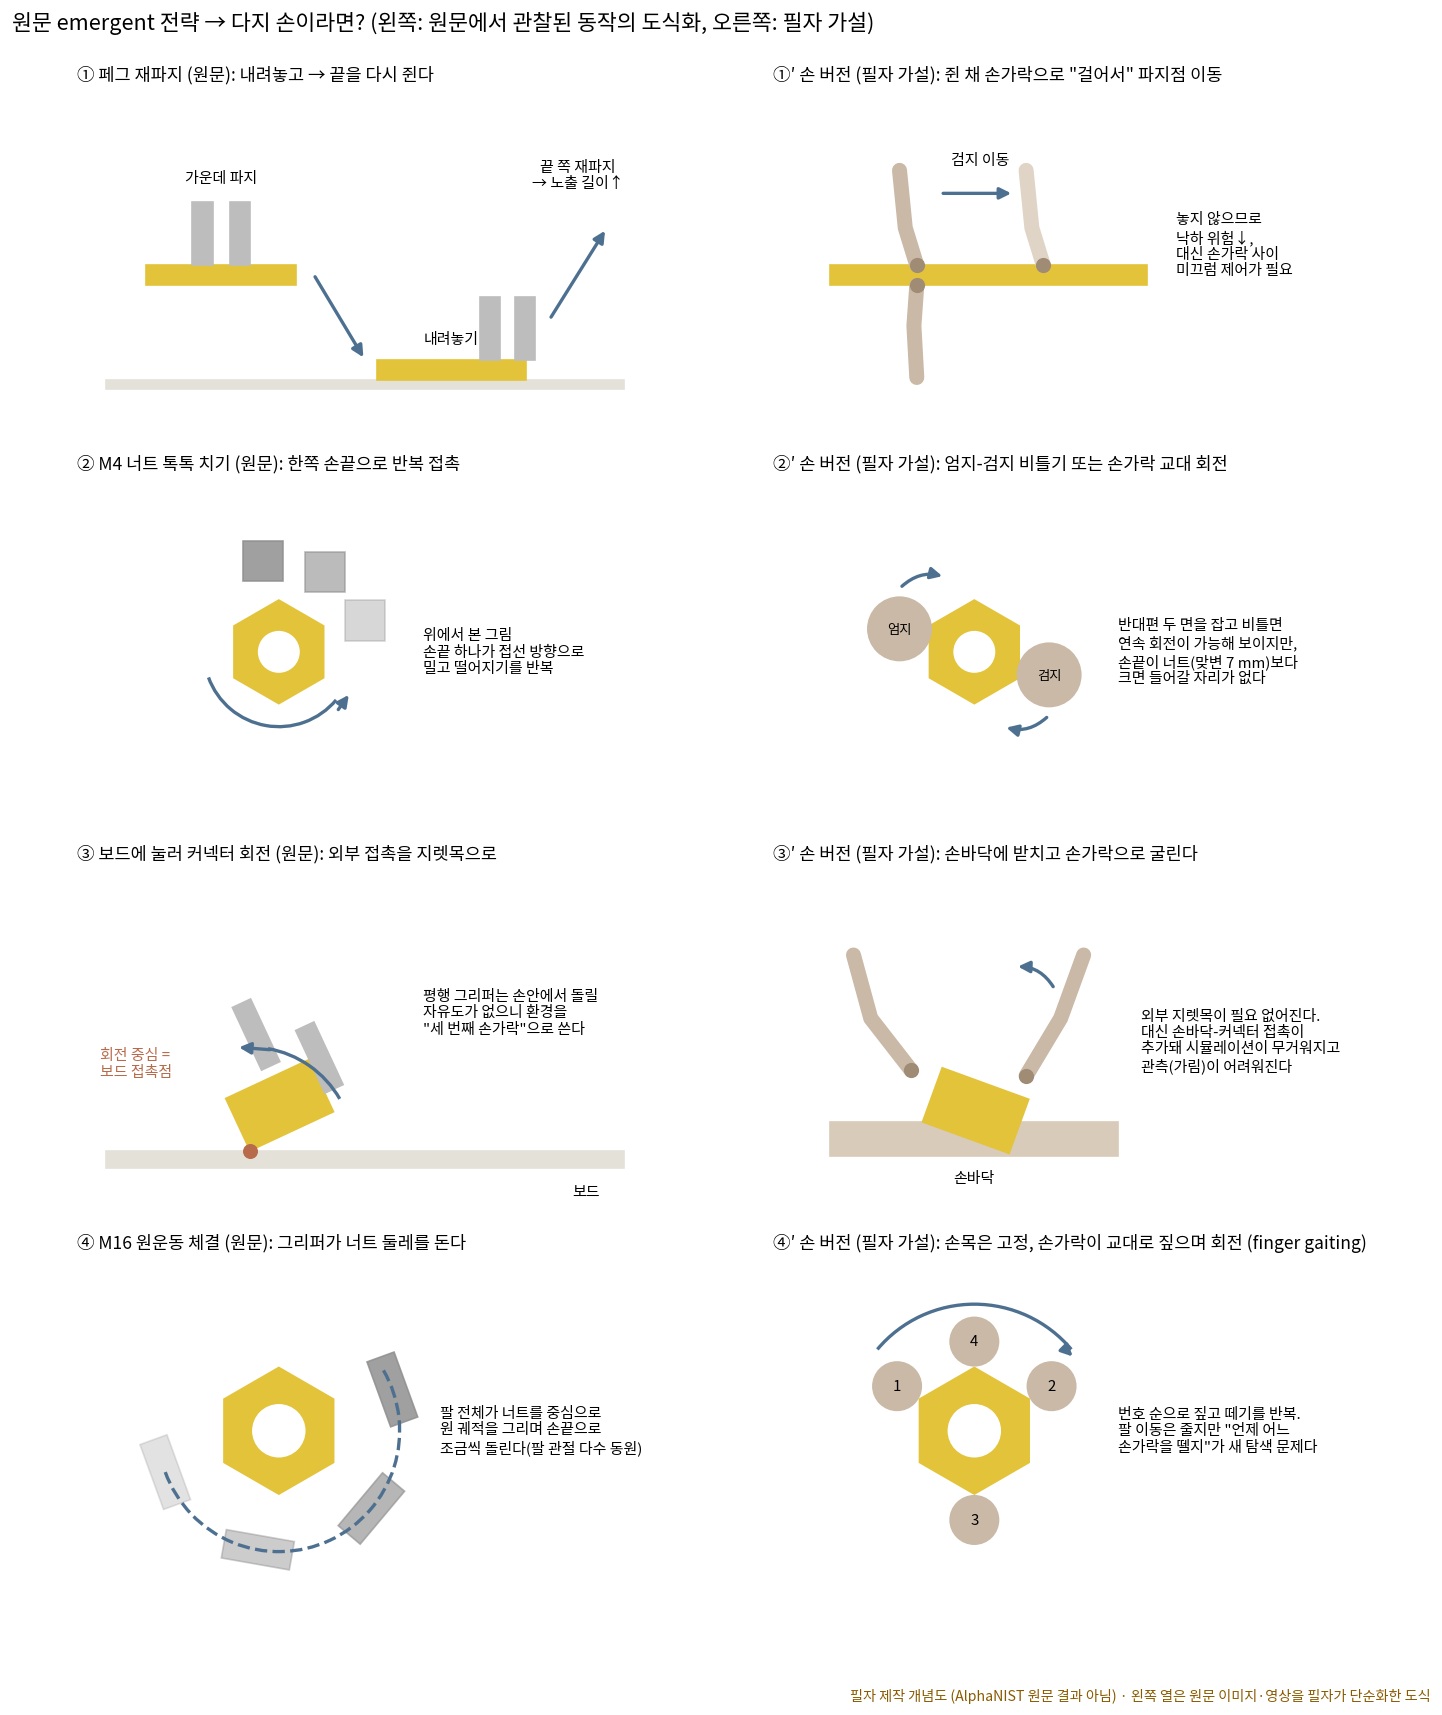
필자 제작 개념도. 왼쪽 열은 원문 이미지와 영상에서 관찰된 동작을 필자가 단순화한 도식이고, 오른쪽 열은 같은 문제를 다지 손이 풀 수 있는 방법에 대한 필자 가설입니다.
원문 전략의 공통점은 앞서 말했듯이 “손 안 조작의 부재를 재파지, 환경 접촉, 비파지 밀기로 대신한다”는 것이었습니다. 다지 손은 손 안 조작(in-hand manipulation)을 직접 할 수 있으므로, 대체 전략의 상당수가 필요 없어집니다.
- 재파지 → 손가락 걸음(finger gaiting). 페그를 내려놓고 다시 쥘 필요 없이, 쥔 채로 손가락을 하나씩 옮겨 파지점을 바꿀 수 있습니다. 대신 “어느 손가락을 언제 떼고 어디에 다시 놓을지”가 새 탐색 문제가 됩니다.
- 보드에 대고 돌리기 → 손 안 회전. 외부 지렛목이 필요 없어집니다. 손바닥으로 받치고 손가락으로 굴리면 됩니다. 대신 손바닥-부품 접촉이 늘고, 손가락이 부품을 가려 point cloud 관측이 나빠집니다.
- M4 톡톡 치기 → 엄지-검지 비틀기? 원리상으로는 두 손가락으로 마주 잡고 비트는 쪽이 효율적입니다. 그러나 이것이 가장 불확실한 항목입니다. 다음 절에서 보듯이 손끝이 너트보다 크면 두 손가락이 들어갈 자리가 없습니다. 오히려 손가락 하나로 톡톡 치는 원문 전략이 손에서도 그대로 다시 나올 가능성이 있습니다.
- 원운동 체결 → 손목 고정 finger gaiting. 그리퍼는 팔 전체로 너트 둘레를 돌아야 했지만, 손은 손목을 고정한 채 손가락을 교대로 짚으며 돌릴 수 있습니다. 이웃 부품을 피해야 하는 상황(원문 “Neighbor-aware turning”)에서는 팔이 덜 움직이는 쪽이 유리합니다.
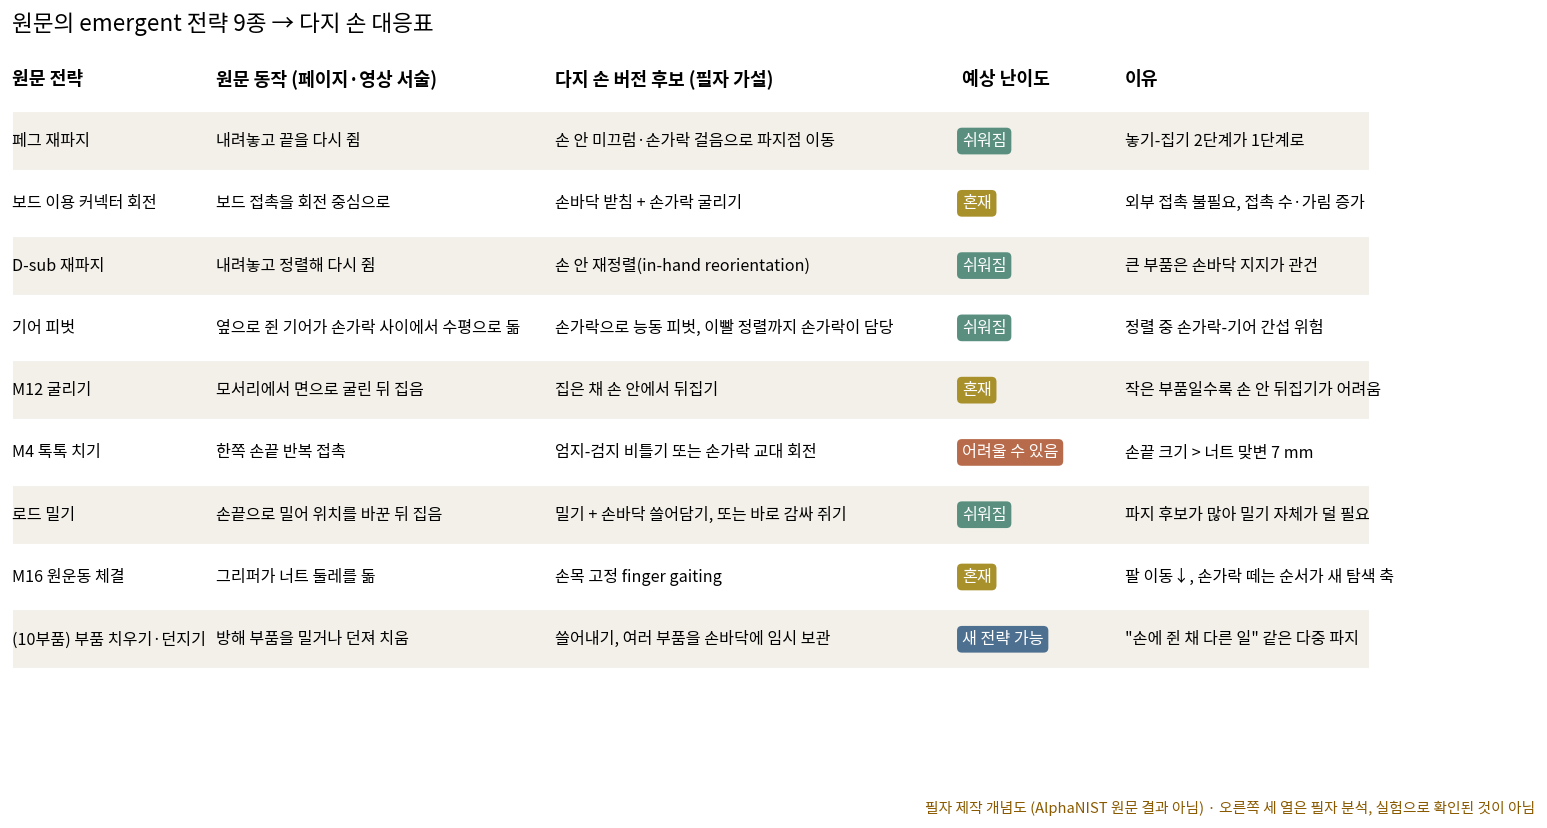
필자 제작 개념도. 원문의 emergent 전략 9종(갤러리 8장 + 10부품 영상의 부품 치우기)과 다지 손 대응 후보. “예상 난이도”와 “이유” 열은 필자의 판단이며 실험으로 확인된 것이 아닙니다.
정리하면 쉬워지는 것은 “자세 바꾸기”(재파지, 재배향, 피벗)이고, 어려워지는 것은 “작은 부품”과 “탐색”입니다. 그리고 10부품 장면에서는 그리퍼에 없던 전략이 생길 수 있습니다. 예를 들어 부품 하나를 손바닥에 쥔 채 다른 손가락으로 방해 부품을 치우는 식의 다중 파지입니다. 반대로 원문의 “던져서 치우기”는 손이 더 정교한 만큼 덜 나올 수도 있고, 보상이 같다면 여전히 가장 싼 해법이라 계속 나올 수도 있습니다. 어느 쪽인지는 예측하기 어렵습니다.
B5. 시뮬레이션: 접촉, 크기, 비용, sim2real, 촉각
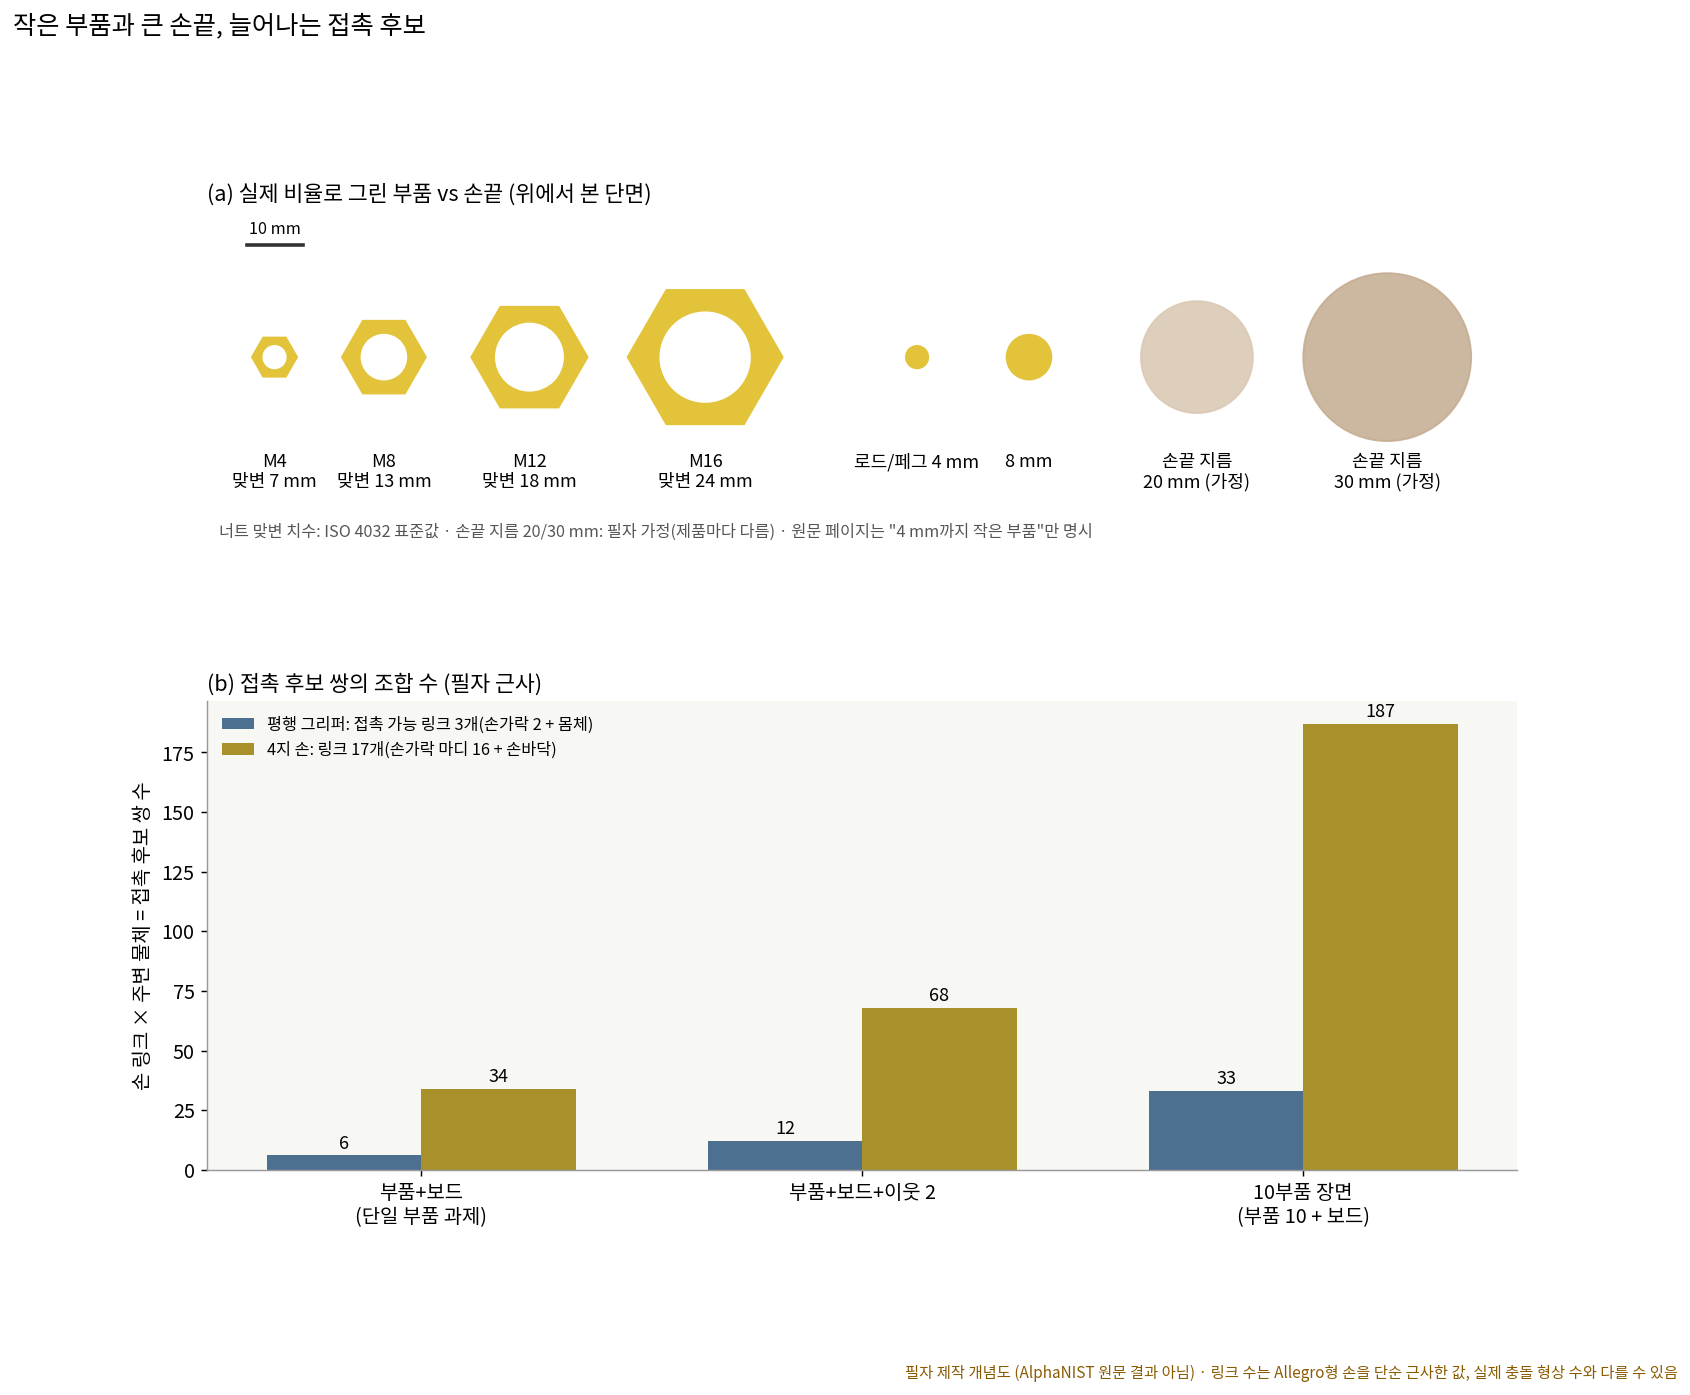
필자 제작 개념도. (a) 실제 비율로 그린 너트(맞변 치수는 ISO 4032 표준값)와 로드, 그리고 손끝 지름 20·30 mm(필자 가정, 제품마다 다름). (b) “손 링크 수 × 주변 물체 수”로 센 접촉 후보 쌍의 조합 수. 링크 수는 Allegro형 손을 단순 근사한 값입니다.
부품 크기 대비 손가락 크기. M4 너트는 맞변이 7 mm(ISO 4032)입니다. 로봇 손끝은 대개 그보다 훨씬 큽니다(그림의 20~30 mm는 가정이지만 자릿수는 맞을 것입니다). 원문 M4 이미지에서도 그리퍼 손끝 패드가 너트보다 눈에 띄게 컸습니다. 다지 손은 손끝이 둥글고 손가락끼리 간격이 있어서, 4 mm 로드나 M4 너트를 두 손가락 사이에 안정적으로 잡는 것 자체가 그리퍼보다 어려울 수 있습니다. 평행 그리퍼의 평평한 패드가 작은 부품에는 오히려 유리합니다. 원문 Fig. 5에서 개별 정책이 무너진 것도 정확히 4 mm 계열이었습니다. 필자는 손 버전에서도 가장 어려운 과제는 4 mm 계열로 남을 것이라고 예측합니다.
접촉 후보 수. 평행 그리퍼에서 부품과 닿을 수 있는 몸체는 손가락 패드 2개와 손 몸체 정도입니다. 4지 손에서는 손가락 마디 16개와 손바닥이 모두 후보입니다. 주변 물체(부품, 보드, 이웃 부품) 수를 곱하면 10부품 장면에서 33쌍 대 187쌍 정도가 됩니다. 이것은 실제 충돌 형상 수가 아니라 자릿수 감각을 위한 근사입니다. 접촉 후보가 많을수록 물리 엔진의 접촉 해석 비용이 늘고, 손가락-부품 사이 접촉이 미끄럼과 구름을 오가는 상황에서 시뮬레이터 오차도 커집니다. 🔗 SGS 논문은 Franka 설정에서 물리 시간 간격 5 ms(200 Hz), 정책 25 Hz를 썼습니다. 손가락 끝의 작은 접촉을 안정적으로 풀려면 이보다 촘촘한 간격이 필요할 가능성이 있고, 그러면 같은 GPU에서 돌릴 수 있는 환경 수가 줄어듭니다. AlphaNIST가 성능의 상당 부분을 “256K 환경”에서 얻었다는 점을 생각하면, 손으로 바꾸는 순간 같은 규모를 확보하는 것 자체가 비싸집니다(✍️ 필자 추정, 구체 배율은 시뮬레이터와 손 모델에 따라 다름).
sim2real. AlphaNIST는 실물 결과가 없습니다. 다지 손의 sim2real 간극은 그리퍼보다 큰 것으로 알려져 있습니다. 손 안 회전을 실물로 옮긴 DeXtreme(arXiv:2210.13702)은 이를 위해 대규모 도메인 랜덤화가 필요했고, Contact Trust Region 리뷰도 이 계열을 다룹니다. 정밀 조립처럼 공차가 작은 과제에서는 손가락 관절의 백래시와 마찰 모델 오차가 그대로 실패로 이어질 것입니다.
촉각의 필요성. 원문 정책의 입력은 point cloud와 로봇 상태입니다. 손에서는 손가락이 부품을 감싸면서 시각 관측이 가려지고, 작은 부품일수록 더 그렇습니다. 손가락이 언제 부품에 닿았는지, 미끄러지는지는 촉각이 가장 직접적으로 알려 줍니다. 손 전체에 퍼진 저가 이진 촉각 센서만으로 손 안 회전을 학습해 실물로 옮긴 Rotating without Seeing 리뷰가 좋은 참고입니다. 이진 보상과 이진 촉각은 잘 어울립니다. 둘 다 시뮬레이터의 기본 접촉 계산으로 값싸게 만들 수 있기 때문입니다(✍️ 필자 의견).
B6. SGS 루프의 손 버전
원문 애니메이션의 구도를 그대로 빌려, 다지 손에 맞게 바꾼 루프를 그렸습니다.
필자 제작 개념 애니메이션(25초). 원문 sgs-method 애니메이션과 같은 4단계 루프를 다지 손 버전으로 그렸습니다. 성공률 변화는 층위별 난이도를 가정한 로지스틱 장난감 역학이며 실험 수치가 아닙니다.
원문과 달라진 부분은 다음과 같습니다.
- 은행이 손 전용 층위 5개로 나뉩니다. A 거의 조립됨, B 정밀 핀치로 쥔 상태, C 감싸 쥔 상태, D 손 안 재배향 중간, E 느슨한 부품. 원문의 데이터 JSON에 나온 층위(공중에서 쥔 상태, 부분 조립 등)에 손 고유의 파지 유형과 재배향 중간 상태를 더한 것입니다.
- 은행 앞에 “파지 합성기”가 붙습니다. B3에서 말했듯이 손의 시작 상태는 종류가 많고, 안정성 확인이 필요합니다.
- 정책 상자의 관측에 “(촉각?)”이 붙습니다. 물음표는 필수인지 아직 모른다는 뜻입니다.
- 오른쪽 위에 “층위별 샘플 비율” 막대가 있습니다. 애니메이션이 진행되면 샘플이 A에서 B·C로, 다시 D로 옮겨 갑니다. 학습 경계가 쉬운 층위에서 어려운 층위로 이동하고, Beta 가중치가 그 경계를 따라간다는 것을 보여 주려는 것입니다. 마지막 단계에서도 E(느슨한 부품) 층위는 대부분 밝은색으로 남는데, 다지 손에서는 “처음부터 끝까지”가 가장 늦게 풀릴 것이라는 필자의 예측을 담았습니다.
B7. 공유 vs 개별 정책, dense 보상의 함정은 유지될까
원문 Fig. 5의 두 결론을 손에 대입한 필자의 예측입니다. 숫자는 없고 방향만 적습니다.
| 원문 결론 | 손에서의 예측(필자) | 근거 |
|---|---|---|
| 공유 정책 > 개별 정책 (98.2 vs 81.4) | 유지되거나 차이가 더 커질 것 | 손가락 걸음, 손 안 회전 같은 기술은 너트·기어·커넥터에 공통으로 쓰입니다. 공유 정책이 한 과제에서 배운 손가락 기술을 다른 과제로 옮기는 효과가 그리퍼보다 클 것입니다. 단, 과제마다 최적 파지 유형이 달라 서로 간섭할 위험도 커집니다. |
| 개별 정책은 4 mm 계열에서 무너짐 | 손에서도 4 mm 계열이 가장 어려울 것 | 손끝 크기 대비 부품 크기(B5). 원문 개별 정책이 무작위 시작에서 4 mm 계열 성공률 0이었던 것과 같은 현상이 공유 정책에서도 나올 수 있습니다. |
| dense 보상이 공유 정책을 무너뜨림 (98.2 → 17.8) | 함정이 유지되거나 더 심해질 것 | 손에서는 “도달·정렬” 진행 항을 손가락 배치가 나쁜 채로도 채울 수 있는 길이 더 많습니다. 정책이 진행 보상을 모으면서 파지는 엉망인 국소해에 머물 가능성이 높습니다. |
| 다만 dense 계열이 손에서 쓸모없다는 뜻은 아님 | 보상이 아닌 다른 자리의 사전 지식은 유효할 것 | TeleDexter는 22-DoF 손에서 희소 subgoal 보상 + 작은 dense 추적 보상으로 성공했습니다. 이것은 원문의 “도달·정렬” shaping과 달리 사람 궤적이라는 외부 참조를 따르는 보상입니다. 원문의 결론은 “그 dense 보상”에 대한 것으로 읽어야 합니다. |
B8. 블로그의 기존 리뷰와 이어 보기
Part B에서 근거로 쓴 리뷰를 한곳에 모읍니다.
- 행동 공간을 줄이거나 다듬는 쪽: NestDex(20차원 손 행동을 10차원 잠재로 압축), DextrAH-G(23자유도 팔-손 + geometric fabric)
- 보상 설계: TeleDexter(22-DoF 손, 희소 subgoal + 작은 dense 추적 보상, Isaac Gym·SAPG)
- 사람 기반 사전 지식: DexTrack, ManipTrans, DexPilot
- 시작 상태 생성기로 쓸 수 있는 파지 데이터: From Grasps to Dexterity
- 촉각과 손 안 조작: Rotating without Seeing
- 손 안 조작의 sim2real: Contact Trust Region(feat. DeXtreme)
요약
원문(AlphaNIST)이 보여 준 것. Franka와 평행 그리퍼가 시뮬레이션에서 NIST 보드 20과제를 이진 보상만으로 학습했습니다. 핵심 장치는 근접 상태를 포함한 시작 상태 은행과, 성공률 50% 근처 상태를 가중하는 \epsilon+\sqrt{p(1-p)} 가중치, 그리고 최대 256K 병렬 환경입니다. 공유 정책 하나가 개별 정책 20개보다 높은 학습 성공률(98.2% 대 81.4%)을 냈고, 도달·정렬 dense 보상을 더하면 오히려 크게 떨어졌습니다(공유 정책 17.8%, 256K 평가에서 −19.9%p). 재파지, 환경 이용 회전, 손끝 톡톡 치기 같은 전략이 저절로 나왔습니다.
원문이 보여 주지 않은 것. 논문·코드·알고리즘·시뮬레이터·행동 공간·실물 실험이 없습니다. Fig. 5는 서로 다른 체크포인트와 규모를 한 그림에 섞었고(데이터 JSON이 스스로 밝힘), 주 지표는 근접 상태가 섞인 학습 중 성공률입니다.
다지 손이라면(필자 분석). 행동 공간이 7~8차원에서 23~29차원으로 커지면서 이진 보상의 “우연한 첫 성공”이 훨씬 드물어지고, 근접 시작 상태조차 쉽지 않게 됩니다. Beta 샘플링은 더 중요해지지만, 은행의 성공률 분포가 한쪽으로 몰리면 샘플링 규칙만으로는 부족하고 은행 구성과 성공률 추정 방식이 성패를 가를 것입니다. 원문의 emergent 전략은 손 안 조작으로 대체되어 쉬워지는 것이 많지만, 4 mm 부품과 손끝 크기의 문제, 늘어나는 접촉과 시뮬레이션 비용, 커지는 sim2real 간극은 손에서 새로 생기거나 더 커지는 어려움입니다. 원문의 원칙 “보상은 결과만”을 손에서도 지키려면, 사전 지식을 보상이 아닌 행동 공간·시작 상태·관측(촉각) 쪽에 넣는 설계가 필요해 보입니다.
참고 링크
- AlphaNIST 프로젝트 페이지 · overview 영상(4:36) · 10부품 영상 · 20과제 영상
- 페이지 데이터:
timeline.json· Fig. 5 데이터 JSON - 관련 프로젝트: SGS 프로젝트 · SGS 논문, arXiv:2610.12465
- NIST Assembly Task Board
- Shadow Dexterous Hand 사양
- 그림 출처 구분:
orig-*·strat-*·fig5-*파일은 원문 asset 또는 원문 영상에서 추출한 프레임이고,b1~b5파일은 필자 제작 개념도입니다.
이 글에 대해
이 글은 논문 리뷰가 아니라 프로젝트 페이지 하나를 읽고 정리한 글입니다. 출처는 alpha-nist.github.io 한 곳이고, 그 페이지가 직접 불러오는 파일(HTML, main.js, timeline.json, Fig. 5의 SVG와 그 데이터 JSON, 영상 5편, 이미지 11장)을 모두 받아서 읽었습니다. 논문·arXiv·코드는 공개돼 있지 않고, 저자와 소속도 페이지에 없습니다.
다만 Fig. 5 SVG의 메타데이터에 “Adapted from paper Figure 5” 라는 문장이 있습니다. 어딘가에 논문 원고가 있다는 뜻이지만 공개된 것은 아닙니다. 그래서 이 글은 페이지에 실린 것만으로 쓰고, 확인되지 않은 것은 “페이지에 명시 없음”이라고 적었습니다.
표기 규칙: 📄 페이지는 HTML 본문, 🎙️ 내레이션은 overview 영상의 음성(필자가 Whisper로 받아 적음), 📊 데이터는 페이지가 함께 배포한 JSON 파일, 🔗 SGS는 페이지가 링크한 관련 프로젝트 SGS의 논문에서 가져온 것, ✍️ 필자는 제 해석입니다.
조회 시점: 2026-10-26. 페이지 asset의 HTTP last-modified는 2026-10-15, 페이지 저장소 alpha-nist/alpha-nist.github.io의 생성일은 2026-09-16입니다.